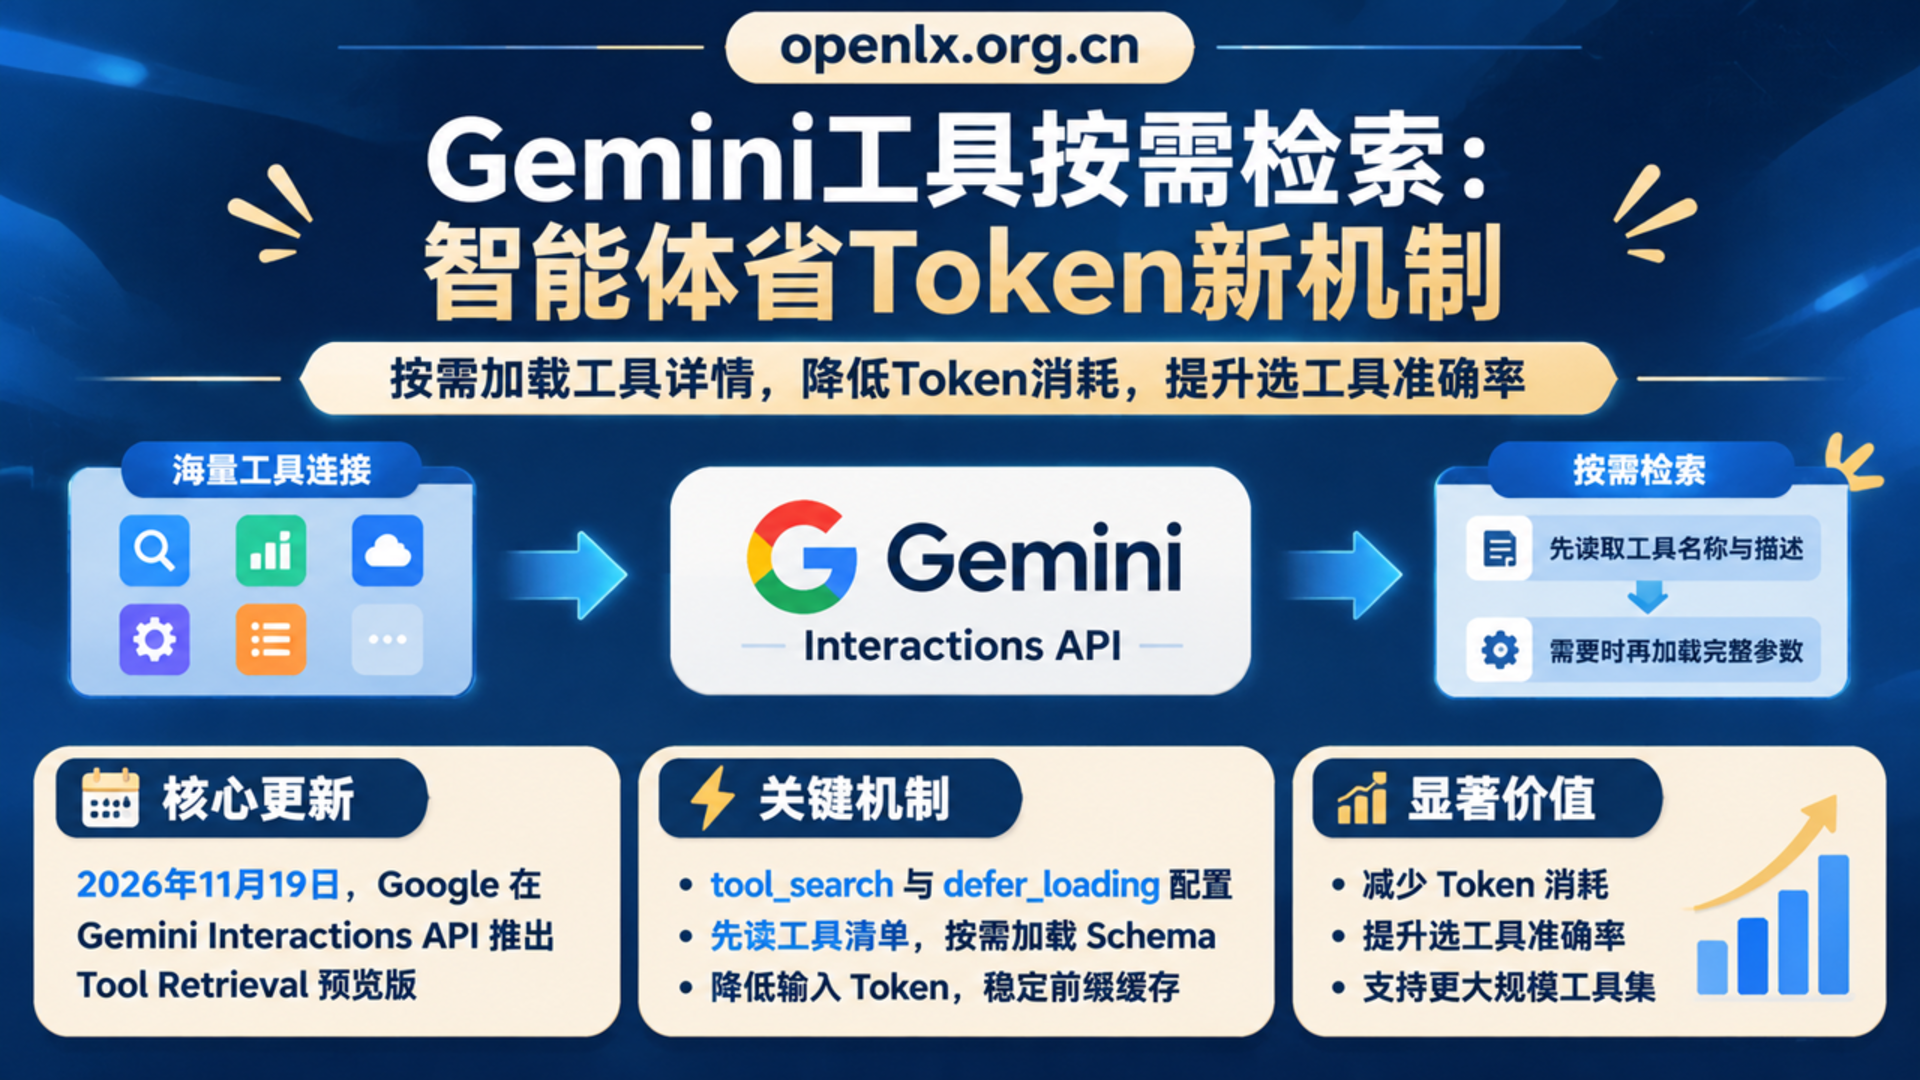
核心摘要:2026年11月19日Google在Gemini Interactions API中推出Tool Retrieval预览版。通过在请求中加入
tool_search并设置defer_loading: true,模型仅先看工具名与描述,待需要时再按需加载完整参数Schema,从而降低输入Token消耗、维持前缀缓存稳定并支持远程MCP服务,已兼容Gemini 3.6及全部Gemini 4模型。
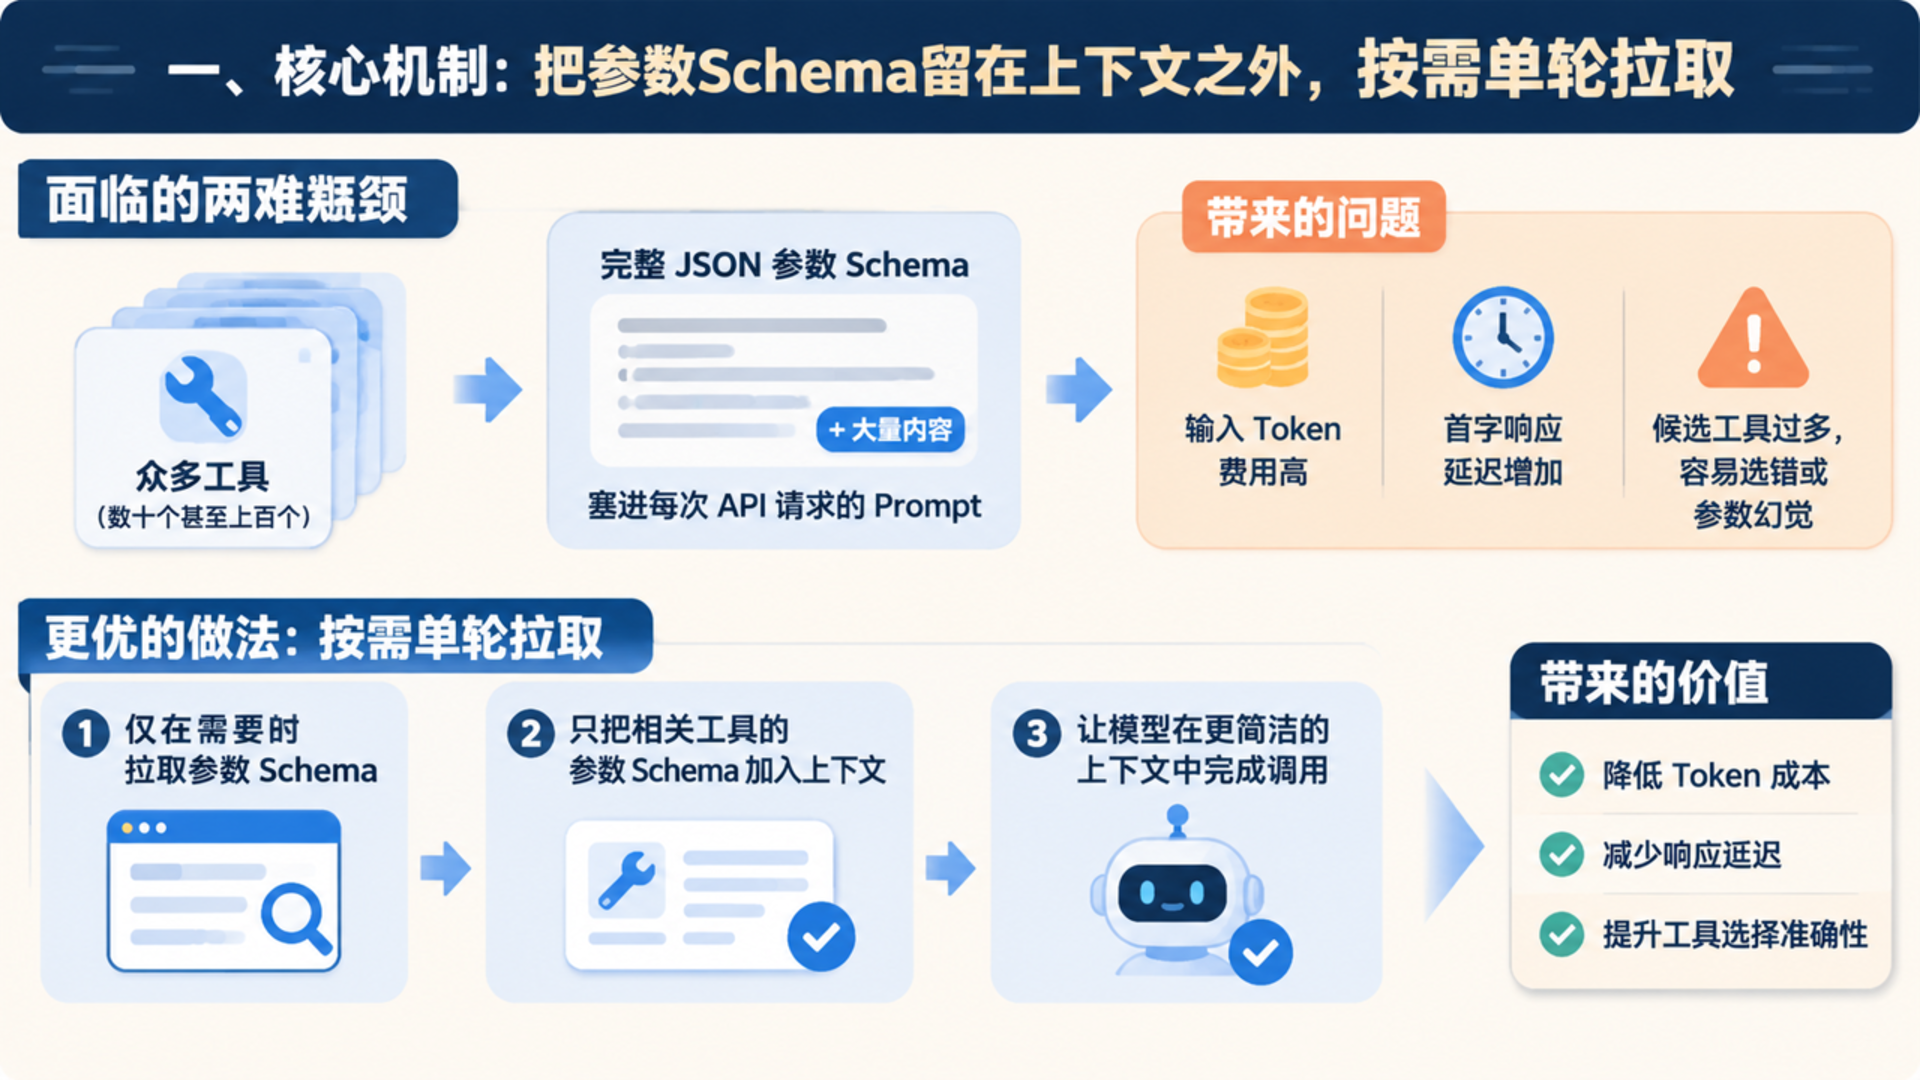
当企业级AI智能体需要对接数十个甚至上百个业务工具时,开发团队很快会遇到一个两难瓶颈:把所有工具的完整JSON参数Schema一股脑塞进每一次API请求的Prompt里,不仅迅速推高输入Token费用和首字响应延迟,还会因为候选工具列表过于庞大而导致模型选错工具或参数幻觉。
2026年11月19日,Google AI团队(Gemini API产品经理Lucia Loher与Google DeepMind研究科学家Nora Kassner)宣布在Gemini Interactions API中上线Tool Retrieval(工具按需检索)预览功能,为大规模工具调用场景提供了一套低改造成本的官方机制。
一、核心机制:把参数Schema留在上下文之外,按需单轮拉取
按照Google官方博客公布的工作流,Tool Retrieval的核心逻辑可以概括为“轻量索引常驻、完整Schema延迟加载”:
- 开启检索与标记延迟:开发者在Interactions API请求中添加
{"type": "tool_search"}工具声明,并对不常使用或长尾的工具设置"defer_loading": true(高频核心工具仍可保留为常规加载)。 - 模型可见性裁剪:在请求初始阶段,模型只能看到所有延迟加载工具的名称(
name)与简要描述(description),完整参数Schema不会进入上下文窗口。 - 单次请求内闭环检索:当模型在推理中判断需要某个工具时,会发出
tool_search_call,服务端随即检索并返回包含完整parameters的tool_search_result,随后模型在同一次API调用内直接生成标准的function_call。
官方示例显示,这三步(tool_search_call、tool_search_result、function_call)全部记录在interaction.steps中,便于工程团队在调试工具命名或描述歧义时直接回溯模型到底检索并考量了哪些工具。
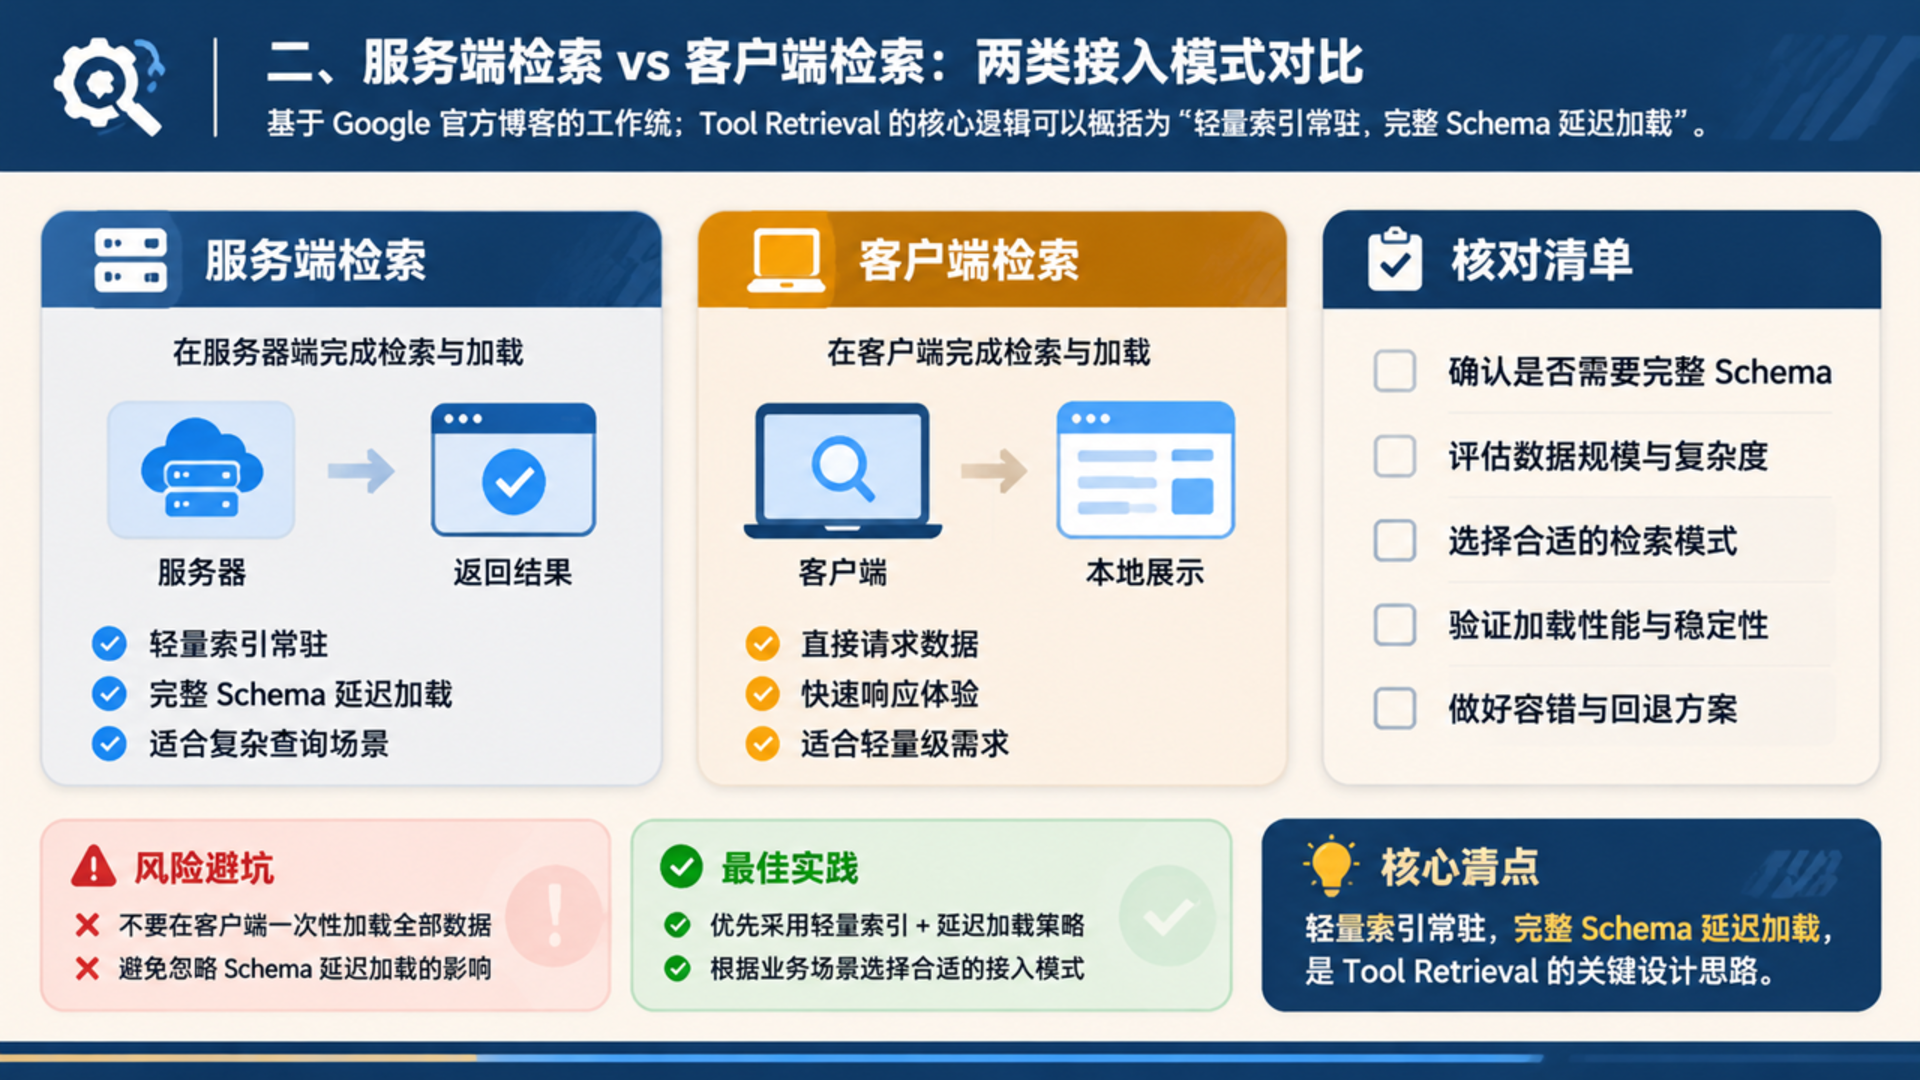
二、服务端检索 vs 客户端检索:两类接入模式对比
针对不同企业的基础设施与权限边界,Gemini API提供了服务端托管与客户端自托管两种检索执行方式,二者在架构复杂度与往返开销上的取舍如下:
| 对比维度 | 服务端检索(默认托管) | 客户端检索("execution": "client") |
| — | — | — |
| 检索执行方 | Google服务端自动完成,无需自建或托管索引 | 调用方应用自行运行工具检索逻辑 |
| 代码改造成本 | 只需增加tool_search并在工具上添加defer_loading: true | 需自定义search_tools参数与previous_interaction_id多轮回传 |
| 网络往返次数 | 单次请求内完成检索并直接输出function_call | 每次检索需增加一次客户端往返(round trip) |
| 适用场景 | 标准化工具库、远程mcp_server整包延迟加载 | 私有工具注册表、自建向量索引、按用户权限动态过滤或会话中新增工具 |
| 额外功能费用 | 无单独检索费,按模型标准输入输出Token计费 | 无单独检索费,按模型标准输入输出Token计费 |
值得重点关注的是两项工程特性:第一,前缀缓存友好(Prefix Caching),由于被延迟的Schema不出现在Prompt开头,后续按需加载的Schema追加在对话后段,跨轮次对话的缓存前缀能够保持稳定;第二,原生支持远程MCP服务,只需在mcp_server工具声明上设置defer_loading: true,即可将大型MCP服务器暴露的全部工具转为按需加载,无需逐条手写展开。
三、计费口径与适配条件:Token账怎么算才不亏
很多团队容易误以为“按需加载”意味着检索工具本身免费且永久省钱。Google在官方说明中给出了明确且克制的计费口径:
- 无独立附加费:Tool Retrieval不收取额外功能费,仍按所调用Gemini模型的标准输入/输出Token单价计费(兼容Gemini 3.6及更高版本,包含全部Gemini 4系列模型,如示例中的
gemini-4-hydrogen)。 - 固定开销与会话留存:开启
tool_search会增加一小段固定的输入Token开销;一旦模型在对话中加载了某个工具的Schema,该Schema就会作为输入Token保留在该对话的后续轮次中。 - 盈亏平衡点:只有当“整场对话中从未被加载的工具Schema体积”大于“检索指令开销 + 实际加载Schema体积”时,才真正实现Token净节省。官方明确建议结合自身真实业务流量测试评估。
四、对文旅AI与多工具MCP平台的实践启示
对于正在搭建多站点内容系统、酒店PMS对接或OTA生态集成的团队而言,一个Agent动辄需要挂载查询房态、核验订单、检索标准库、调用COS归档等几十上百个函数。将高频核心工具保持常驻、把低频管理与长尾MCP工具标记为defer_loading: true,是现阶段兼顾响应速度与工具选择准确率的可行路径;而涉及租户级权限隔离或内部私有工具目录时,则更适合采用"execution": "client"模式在本地完成权限过滤后再向模型返回Schema。
常见问题(FAQ)
Q1:Gemini API的Tool Retrieval支持哪些模型和接口?
根据Google 2026年11月19日公告,该功能目前在Gemini Interactions API中提供预览版,支持Gemini 3.6及之后版本(包括全部Gemini 4模型)。
Q2:接入远程MCP服务器时是否需要手动列出每个工具?
不需要。在mcp_server工具上设置defer_loading: true后,该远程MCP服务器暴露的所有工具都会转为按需加载。
Q3:使用Tool Retrieval一定会减少Token消耗吗?
不一定。启用tool_search存在固定Token开销,且已加载的Schema会留在后续对话输入中;当工具库较大且单次任务仅命中少数工具时才能净省Token,需依据真实流量测算。
本文依据Google AI Blog于2026年11月18日/19日发布的《Introducing Tool Retrieval in the Gemini API》公开技术文档梳理,文中示例代码与支持口径以原文发布时点为准。
本文首发于 中国文旅AI可见度指数平台(https://jogeo.cn/),转载请注明出处与完整链接。