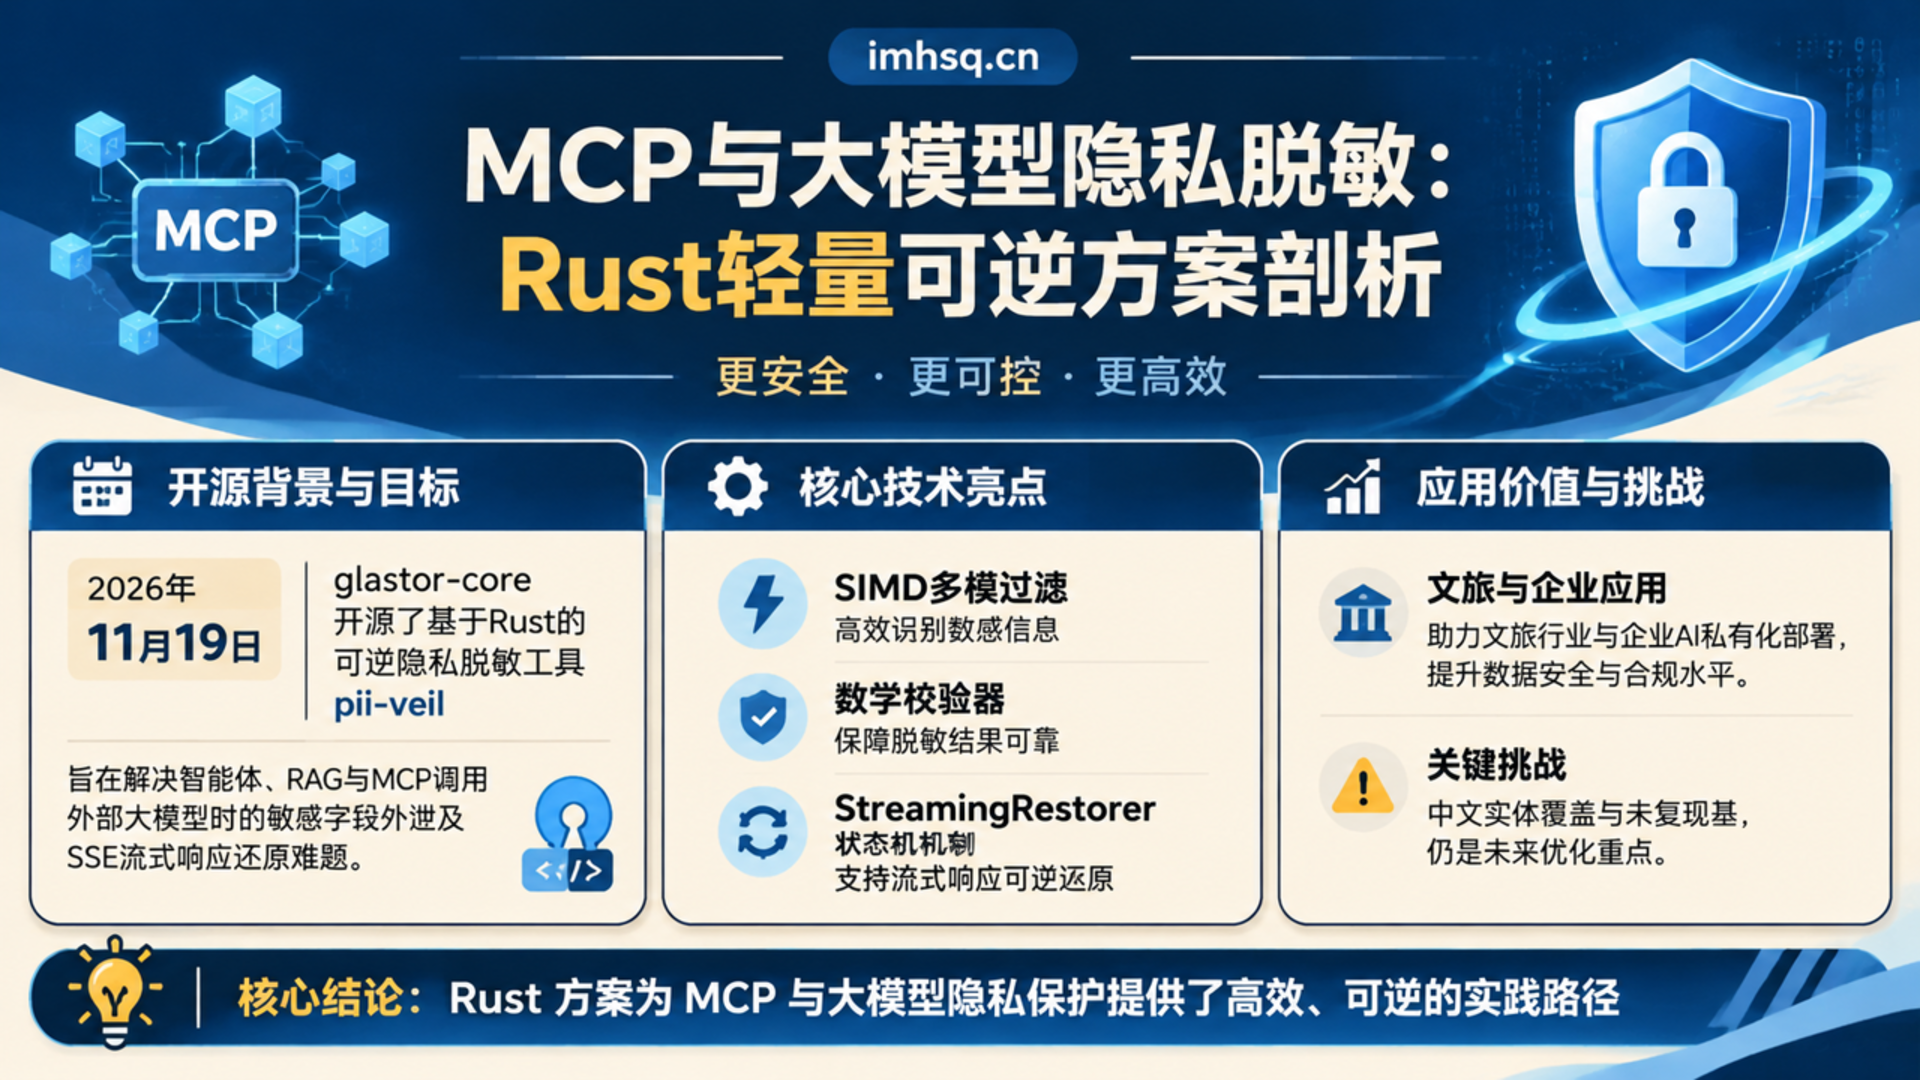
核心摘要:2026年11月19日,glastor-core开源了基于Rust的可逆个人隐私信息脱敏工具pii-veil,用于解决AI智能体、RAG与MCP调用外部大模型时的敏感数据外泄与SSE流式响应还原难题。本文结合其公开技术文档与基准口径,拆解该方案的无外发架构、流式状态机与部署边界,供企业AI落地选型参考。
企业在实际落地大模型工作流、RAG知识库以及Model Context Protocol(MCP)工具链时,往往绕不开一个非常现实的工程隐患:业务系统送往外部模型接口的提示词里,经常夹杂着客户邮箱、银行卡号、税号、数据库连接串甚至内部API密钥。我们在观察文旅与专业服务团队试水AI部署时也反复看到,很多项目卡在合规评审这一关,不是因为模型能力不够,而是无法证明敏感字段不会明文离开本地边界。
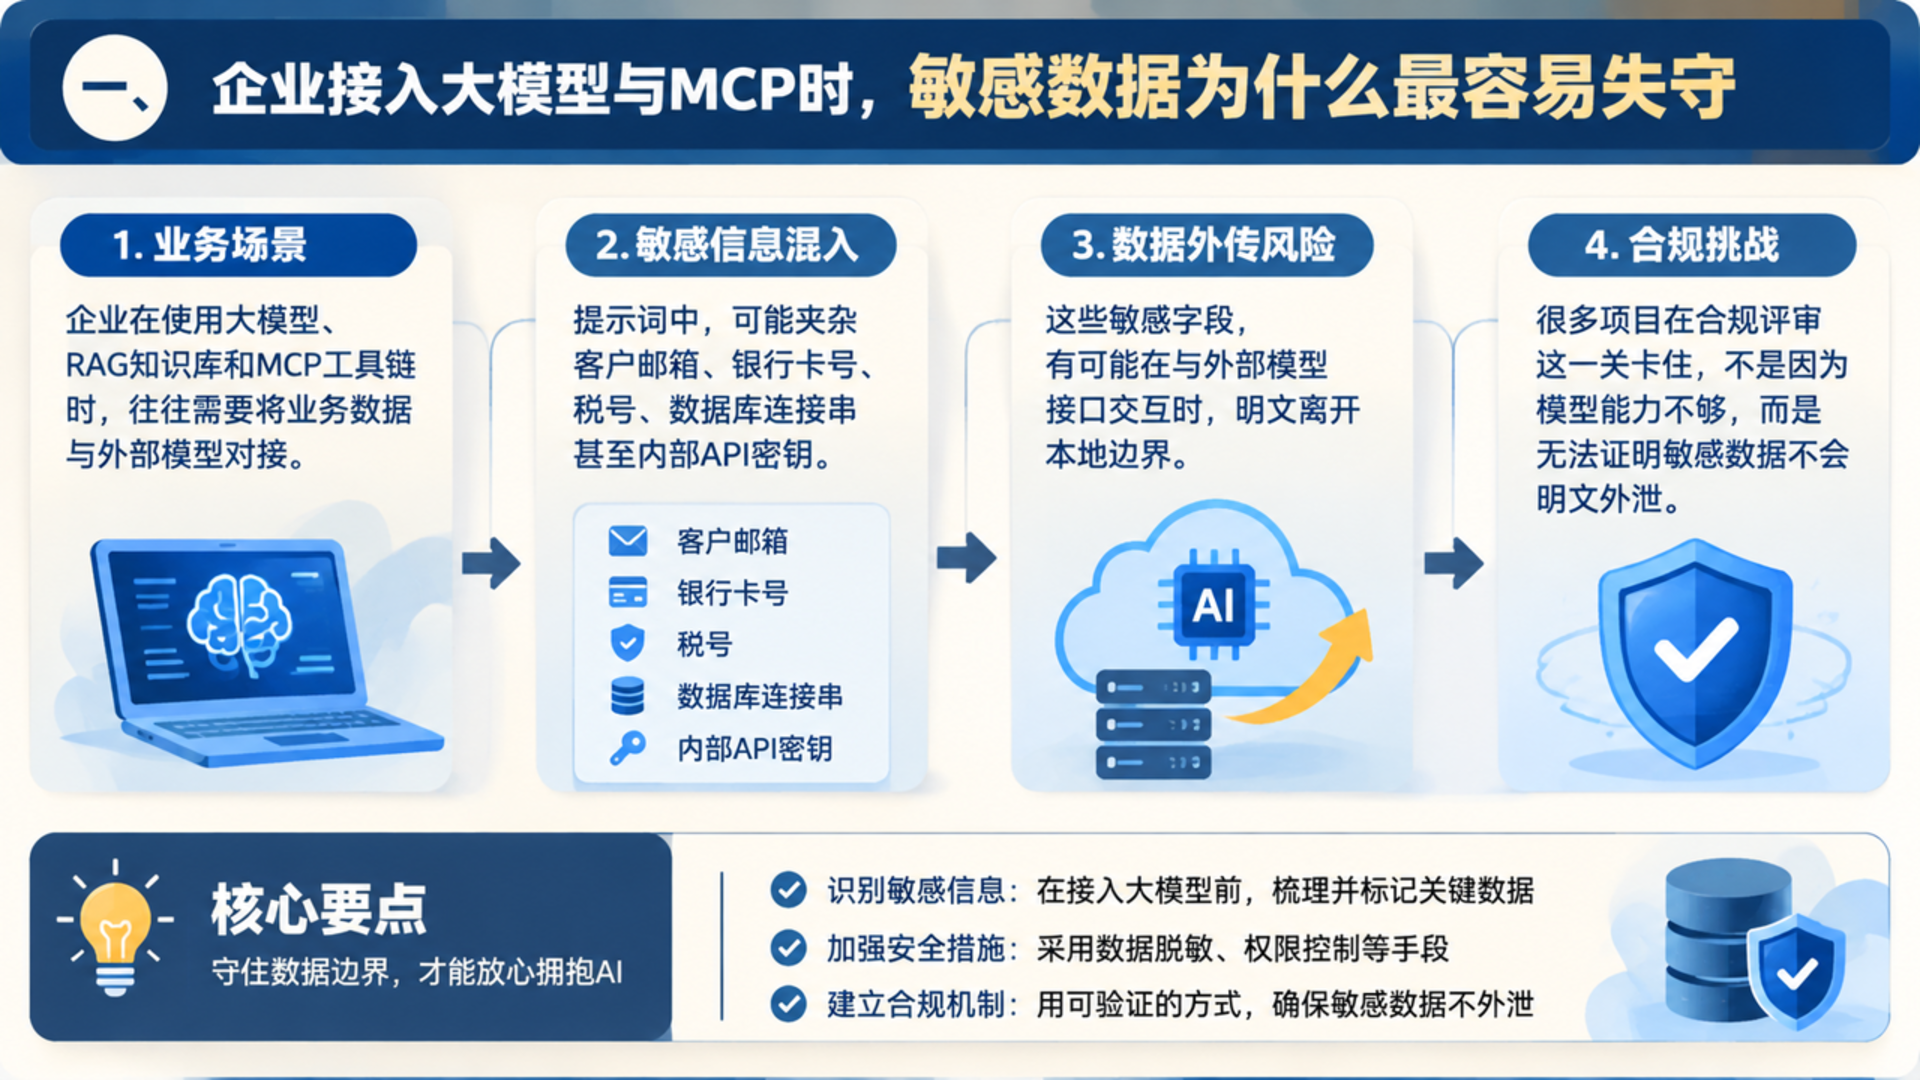
一、企业接入大模型与MCP时,敏感数据为什么最容易失守
目前行业内常见的隐私保护路线主要有两类,但在高并发代理和实时交互场景下各自存在明显短板。
一类是基于Python的自然语言处理管线(以Microsoft Presidio搭配spaCy为代表)。根据glastor-core于2026年11月19日在DEV Community公开的技术文章说明,这类方案处理单次提示词通常需要约35毫秒,常驻内存占用约450MB,且原生不支持对大模型流式返回的SSE分片进行还原。对于追求轻量化边缘部署或高密度并发的网关服务而言,内存开销与冷启动负担都偏重。
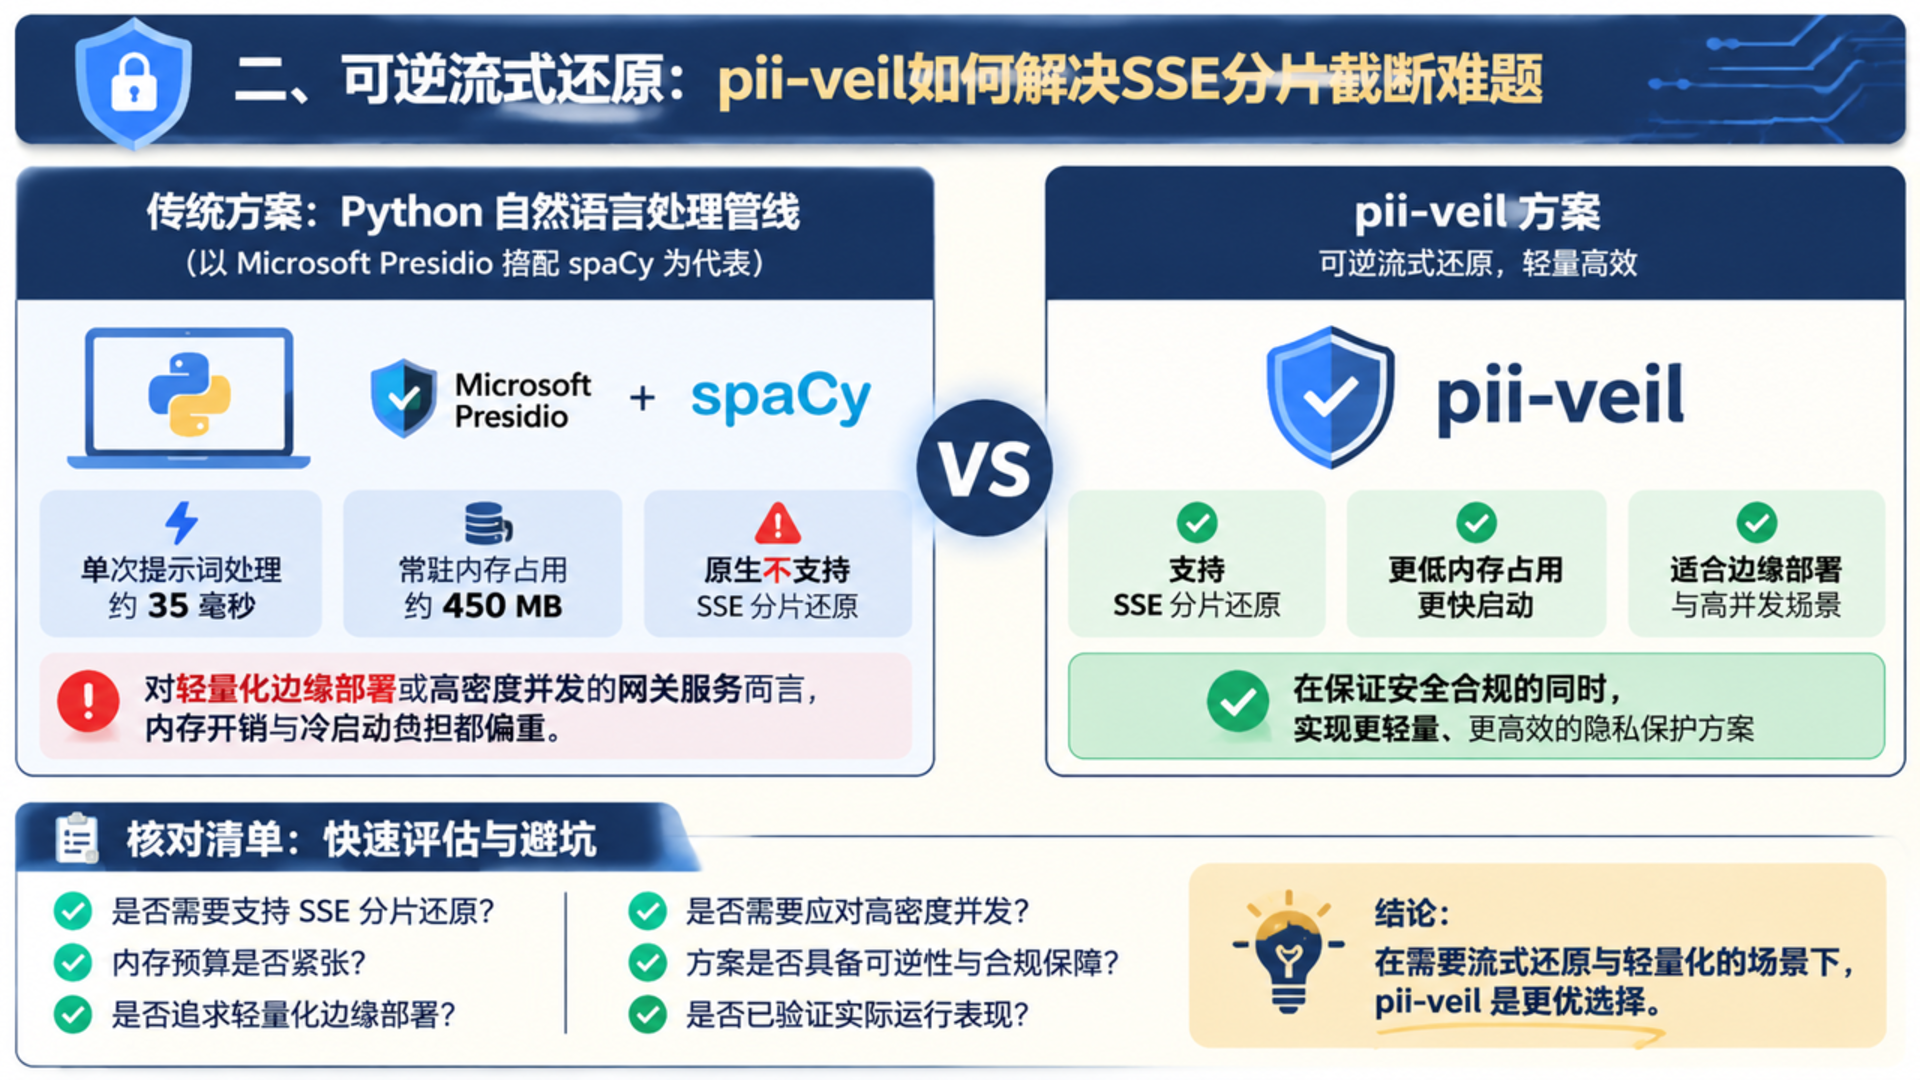
另一类是直接调用云厂商的敏感数据识别接口(如AWS Comprehend PII)。公开对比指出,此类云端API存在80至250毫秒的网络往返延迟,每百万次请求成本超过100美元,更重要的是企业仍需先将原始敏感文本通过网络发送给第三方云服务,难以满足严格意义上的本地“零外发”合规前提。
正是在这样的工程约束下,glastor-core用Rust开发并开源了pii-veil(代码仓库公开于GitHub,并提供纯浏览器端运行的WebAssembly演示页)。其核心思路并不复杂:放弃加载几百兆的机器学习模型,改用SIMD加速的Aho-Corasick多模匹配预过滤,配合Luhn算法(信用卡校验)、ISO 13616 Mod-97(IBAN国际银行账号校验)以及多国税号校验等18类数学校验器,在本地完成高精度结构化敏感信息识别,从根源上降低误报并压缩资源占用。
二、可逆流式还原:pii-veil如何解决SSE分片截断难题
仅仅在请求发出去之前把敏感词替换成占位符,只解决了一半问题。真实业务中,模型不仅需要理解上下文,还会把占位符带进回复里,例如把原邮箱替换为[EMAIL_1]、把卡号替换为[CREDIT_CARD_1]后,大模型返回的文本就会包含这些语义占位符。
生产环境下的大模型通常通过Server-Sent Events(SSE)逐个Token流式吐出内容,占位符极易在传输边界被切碎。例如[EMAIL_1]可能在前一个数据块里只到达了[EMA,后一个数据块才收到IL_1]。如果网关只用简单的正则匹配按块替换,遇到跨块截断就会直接失效,导致用户端看到残缺的占位符代码;如果为了凑齐正则而整段缓冲等待全部输出,又会抵消流式响应的首字延迟优势。
根据pii-veil公开架构说明,该项目为此设计了名为StreamingRestorer的状态机缓冲区:它在SSE数据流经过代理层时实时检测块边界处的占位符前缀,在不缓存整篇响应的前提下完成跨块拼接与还原,原文公布的SSE分片还原耗时为每块69.65微秒。此外,该工具内置了三类即插即用的接入形态,适合不同阶段的工程集成:
- 本地加密保险库CLI:通过
veil redact与veil restore配合经认证的加密保险库文件完成脱敏与还原,确保映射关系留存本地。 - HTTP/SSE透明代理与MCP服务:运行
veil proxy即可在本地监听端口透明清洗出站JSON载荷并还原入站text/event-stream流;运行veil mcp则可通过stdio提供符合JSON-RPC 2.0规范的MCP服务端,直接向支持MCP的桌面或编码客户端暴露脱敏与扫描工具。 - CI/CD防泄漏门禁:提供GitHub Action规则,在代码提交阶段拦截误传的密钥与敏感配置。
三、开源基准对比与适用条件:轻量确定性方案的得与失
为了更直观地看清技术取舍,下表整理了glastor-core在标准x86_64硬件环境下通过Rust criterion基准套件公布的对比数据,需特别说明以下数值均来自项目方公开基准报告,尚未在本方生产业务环境下完成独立复现验证。
| 评估维度 | GLASTOR pii-veil | Microsoft Presidio | AWS Comprehend PII |
| — | — | — | — |
| 典型提示词延迟(1KB,7个实体) | 165.68 µs(0.165 ms) | ~35 ms | ~140 ms |
| 单实体扫描延迟 | 4.01 µs | ~12 ms | ~90 ms |
| 1 MB 吞吐缓冲耗时 | 20.58 ms(~46.3 MiB/s) | ~4,200 ms(4.2 s) | 不支持 |
| 原生SSE流式分片还原 | 支持(69.65 µs / 块) | 不支持 | 不支持 |
| 运行内存占用 | < 15 MB(Distroless) | ~450 MB(spaCy) | 云端托管服务 |
| 每百万次请求边际费用 | $0.00(自托管) | 仅本地算力成本 | $100.00+ USD |
从架构取舍来看,pii-veil之所以能把单次处理压缩到微秒级,核心原因在于它用“零拷贝切片 + 确定性规则与数学校验”替代了重型NLP推理。这意味着它对格式规范的邮箱、卡号、银行账户、数据库连接串、API密钥和标准证件号极为高效且稳定;但反过来讲,如果企业需要识别缺乏固定格式的中文人名、非标准地址、复杂口语化家庭住址或行业特定非结构化实体,纯正则与校验和机制就存在天然盲区,这恰恰是传统NLP模型或本地小参数语义模型更擅长的领域。
四、文旅与企业AI私有化部署的选型边界与验证清单
站在OpenLX长期推动企业AI部署与可信信源建设的视角,我们非常关注这类零外发、低内存的网关级组件,但它绝不是“装上就万事大吉”的银弹。企业技术负责人在评估是否将pii-veil引入内部RAG或Agent代理链路时,建议把以下四条边界核对清楚,避免把开源宣传数据直接等同于生产结论:
第一,明确数据源与未复现边界。本文中引用的微秒级延迟与450MB内存对比均出自项目方公开基准(2026年11月19日发布),且主要针对英文及拉丁语系常见证件校验规则(如Luhn、IBAN及西班牙、阿根廷、智利税号);在中文文旅订单、住宿登记、会员手机号与身份证号等本土格式场景下,必须先用真实脱敏样本补写本地规则并开展压测,再决定是否接入生产网关。
第二,区分“结构化防泄漏”与“语义级脱敏”。对于文旅集团财务对账、OTA结算API调试、研发团队使用MCP连接内部数据库等强结构化场景,轻量级Rust代理几乎可以做到无感防护;但对于客服工单分析、民宿客诉长文本摘要等高度依赖自然语言上下文的任务,仍需结合本地化部署的轻量级实体识别模型或人工抽检机制,防止因非标准表述漏检而产生合规风险。
第三,守住密钥与映射库保管底线。可逆脱敏意味着“占位符—真实值”映射表本身就是高敏资产。无论采用本地加密保险库还是内存态会话映射,都必须严格限定访问权限、设置会话过期自动销毁策略,并避免将还原后的明文日志再次写入外部监控平台。
总体而言,pii-veil展示了AI基础设施正在从“重模型堆叠”向“网关层确定性工程”演进的一个务实方向:用极低的资源代价把可验证的安全边界前置到代理入口。至于它是否适合你的业务流,最稳妥的做法依然是先在隔离测试环境里跑一遍真实样本、校验本地正则覆盖率,再谈上线交付。
本文首发于 中国文旅AI可见度指数平台(https://jogeo.cn/),转载请注明出处与完整链接。