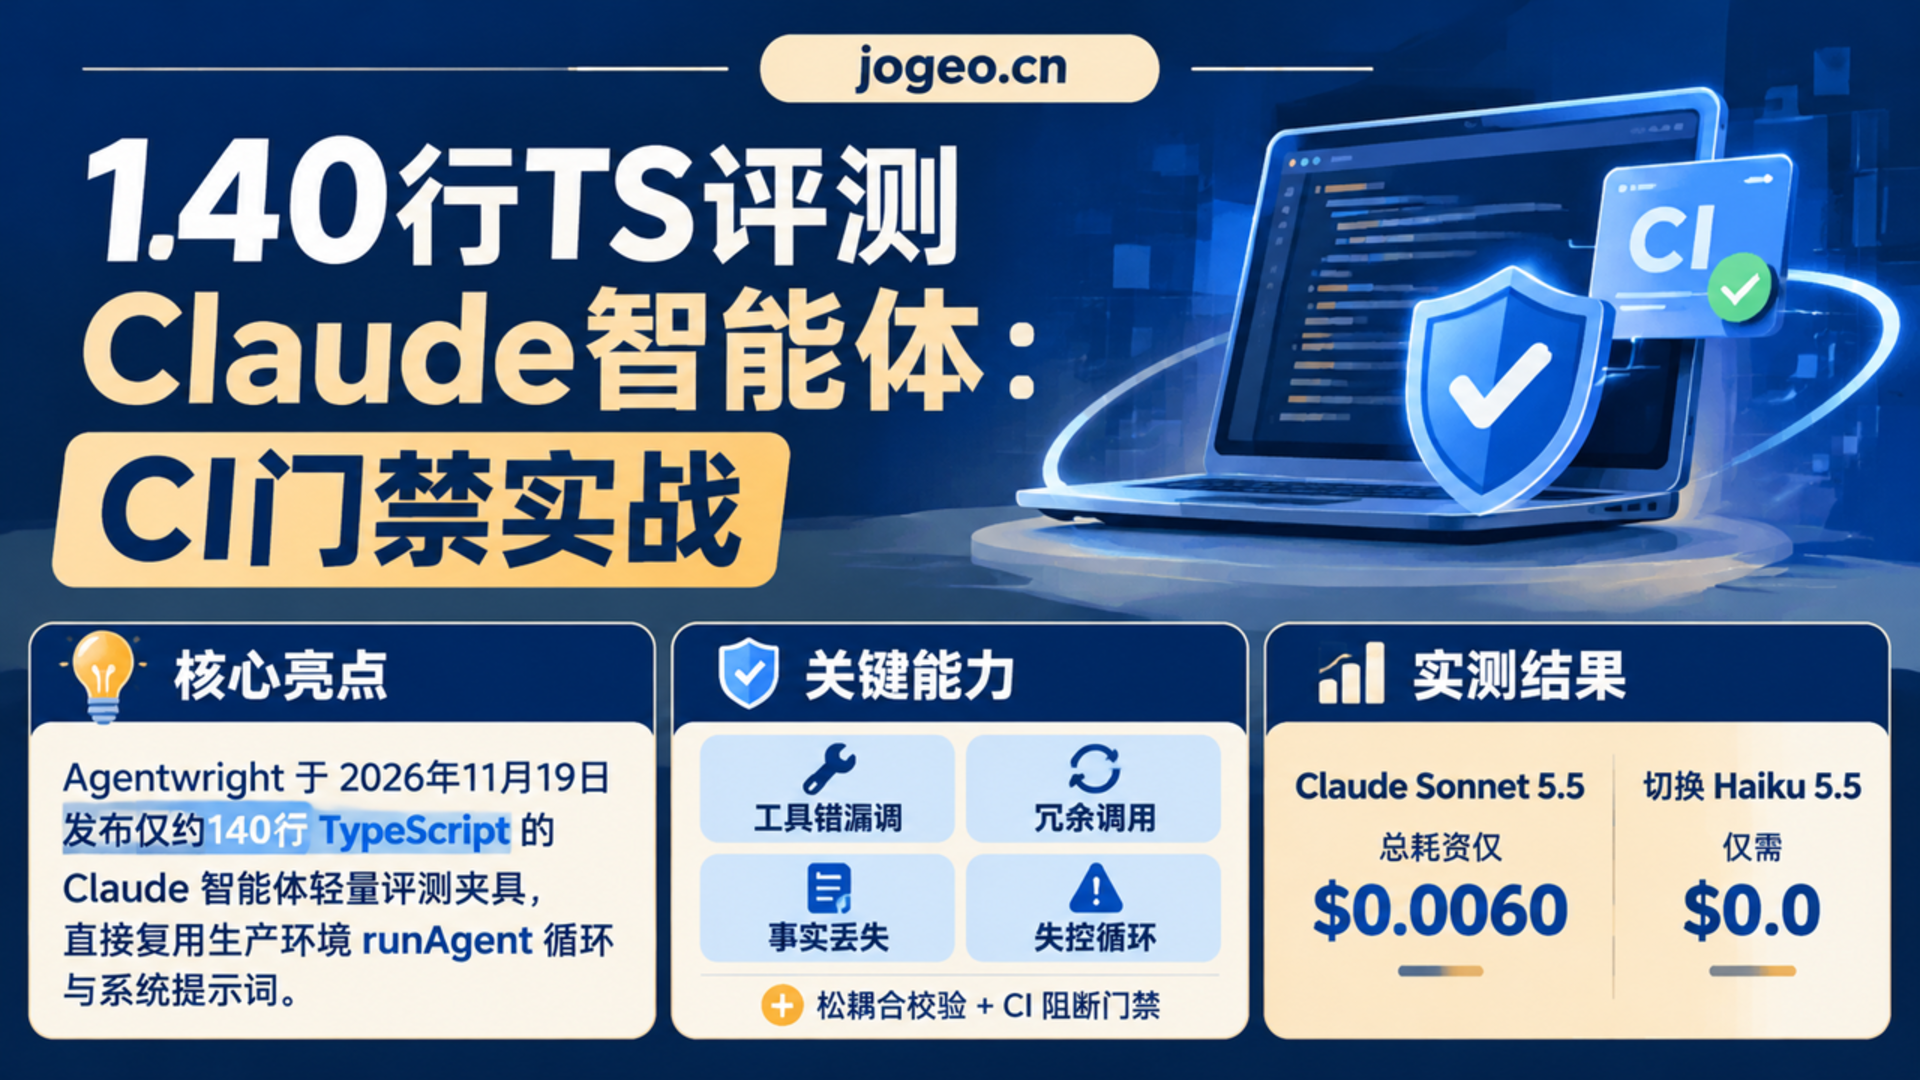
核心摘要:Agentwright于2026年11月19日分享了一套仅约140行TypeScript的Claude智能体评测方案:直接复用生产环境
runAgent循环、以松耦合条件校验四类典型回归,并在GitHub Actions设置CI拦截门禁。公开测试3条基准用例在Claude Sonnet 5.5耗时合计$0.0060,切换Haiku 5.5仅需$0.0003,为AI应用与可见度评测提供了低成本确定性校验范式。
单元测试能证明某个工具函数代码本身没有语法错误,但它回答不了一个更致命的问题:当你微调了一句系统提示词(System Prompt)、换了一个更便宜的推理模型,或者新增了一个描述相近的工具时,AI智能体还能否稳定选对工具、不胡乱编造数据、不陷入死循环?
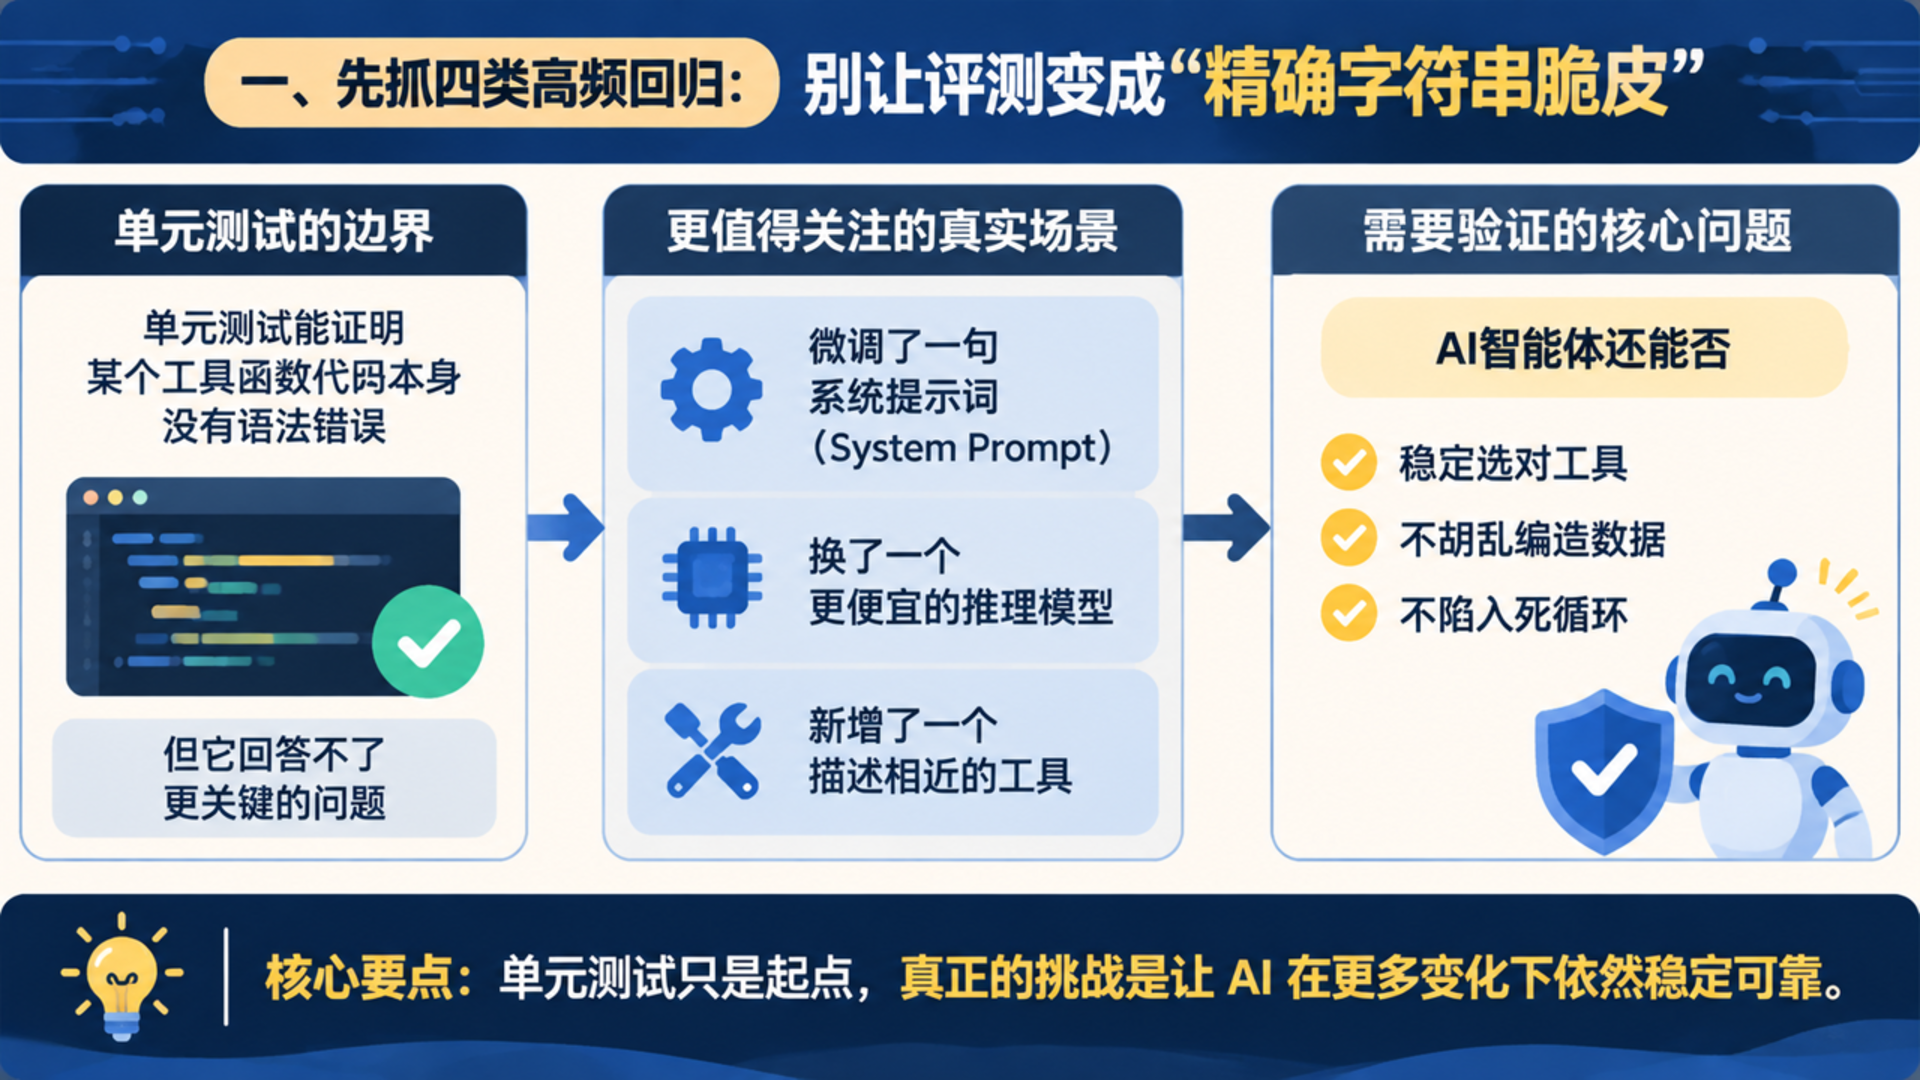
2026年11月19日,开发者团队Agentwright公开了他们正在生产中使用的轻量级评测夹具(Harness)——不依赖庞大复杂的外部评测框架,全部核心代码加起来仅约140行TypeScript,就能把确定性用例校验、单次调用成本核算和CI退出码集成到一起。
一、先抓四类高频回归:别让评测变成“精确字符串脆皮”
Agentwright指出,大多数智能体在迭代后出现的退化,往往集中在四个具体症状上,而且全部可以用普通确定性代码直接拦截,无需额外再请一个“裁判大模型”打分:
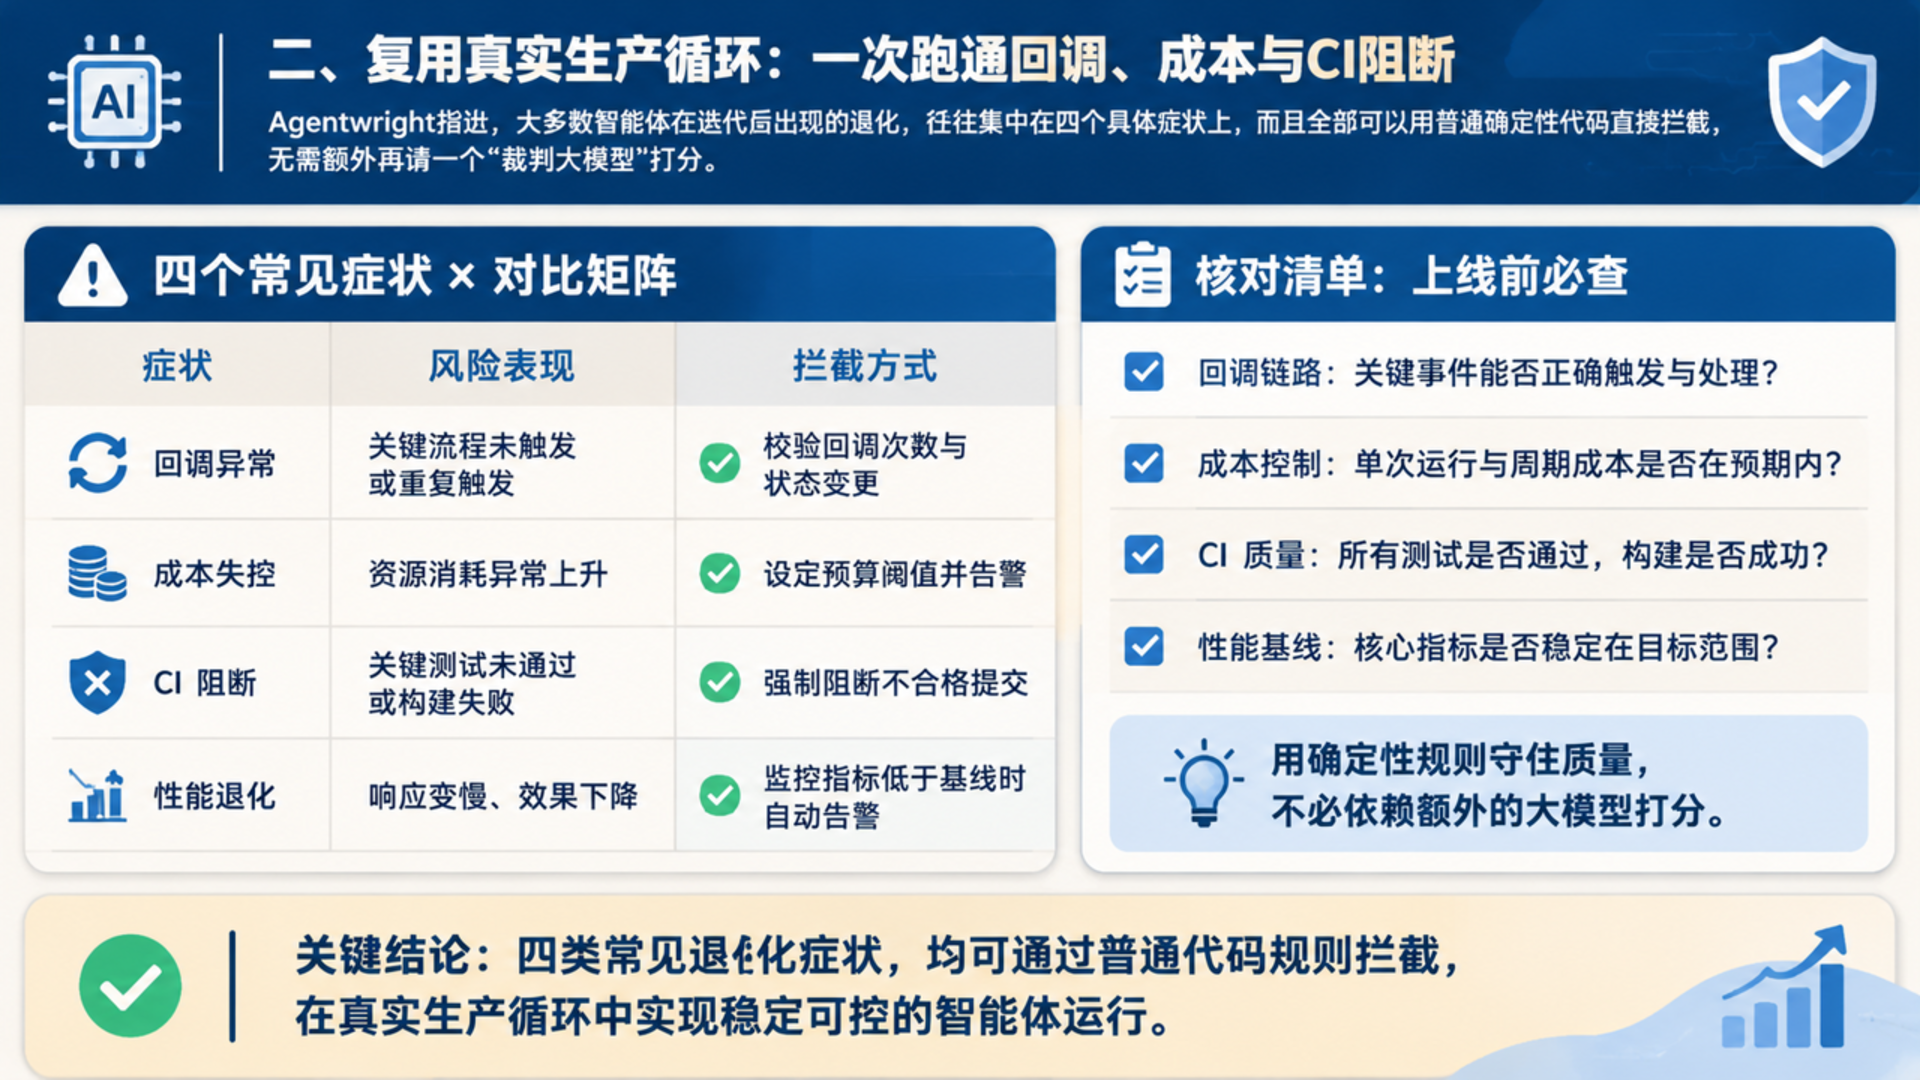
- 该用工具不用或用错工具:例如该查询实时接口时却凭记忆作答,或者把
get_order调用成了search_orders。 - 不该用工具却乱调工具:简单算术或常识问题触发了冗余外部查询,白白增加费用和延迟。
- 工具查对了但回复丢了关键事实:下游接口明明返回了正确字段,最终回答却遗漏或改错了核心数值。
- 失控循环(Runaway loops):原本一步能解决的任务,模型反复调用工具十几次仍未收口。
为了防止评测因为模型措辞微调而频繁误报(Flaky),其cases.ts设计刻意保持宽松校验:支持expectTools(必须调用的工具)、expectNoTools(严禁调用工具)、includes(忽略大小写的子串命中,如"391"即可兼容多种句式)、matches(正则匹配)以及maxTurns(轮次上限)。作者特别强调了一项常被忽视的用例——honest-limits(诚实承认能力边界),用来验证当模型没有发邮件工具时,能否明确告知无法完成,而不是在改完Prompt后开始“假装已经发送成功”。
二、复用真实生产循环:一次跑通回调、成本与CI阻断
该方案最关键的架构原则在于“评测必须穿过和生产完全一致的runAgent函数、同一份SYSTEM_PROMPT以及同一套工具注册表”。如果评测脚本自己另写一套API调用代码,测出来的只是副本而非线上系统。
利用流式界面本来就有的onText、onToolCall、onTurn三个回调函数,run.ts在不依赖数据库的前提下即可无痛采集响应文本、工具序列、总轮次以及input / output / cacheRead / cacheWrite四类Token用量,并换算为微美元成本(costMicroUsd)。
| 对比模型 / 评测维度 | Claude Sonnet 5.5 | Claude Haiku 5.5 | 工程与可见度治理启示 |
| — | — | — | — |
| 测试基线范围 | tool-use-time、no-tool-arithmetic、honest-limits(3条) | 同左 3 条基准用例 | 覆盖工具必选、禁调工具与拒答边界三类核心场景 |
| 公开测试通过率 | 3/3 通过 | 3/3 通过 | 用客观通过率替代主观体感,为降本换模提供证据 |
| 3条总计费用 | $0.0060(6毫美元) | $0.0003(大幅低于Sonnet 5.5) | 几十条核心用例跑一次成本仍远低于$0.01 |
| CI门禁触发策略 | 按lib/agent/与evals/路径变更触发 | 推荐CI默认跑Haiku快速门禁 | 改CSS不触发评测,兼顾阻断精准度与零浪费 |
文中展示的2026年11月4日公开测试输出显示,Sonnet 5.5跑完tool-use-time(2轮、2114ms、$0.0024)、no-tool-arithmetic(1轮、1130ms、$0.0009)与honest-limits(1轮、2275ms、$0.0027)总计仅$0.0060;而切换至Haiku 5.5后同样3/3通过且总花费仅$0.0003。在GitHub Actions中,只要任意一条失败即通过process.exit(1)阻断PR合并。
三、对AI搜索可见度评测与质量门禁的借鉴意义
对于关注大模型引用准确率、文旅AI问答可信度以及自动化工作流稳定性的平台而言,这套140行思路有三点直接可落地的启发:
- 每一条线上Bug先变成一条回归用例:先看它在评测表里亮红灯,再修改提示词或工具描述,直到转为PASS,并把模型名称、日期与当时采用的计价表快照一起存为JSON结果,方便跨月对比可见度与成本漂移。
- 确定性规则优先,语义打分补位:先用子串、正则、工具白名单与轮次上限拦截大多数硬伤,只有在语气、摘要忠实度等无法硬编码的维度上,才按需叠加模型辅助评分。
- 串行执行保稳定:作者故意让用例顺序串行执行而非并发轰炸,十来条用例一分钟内即可跑完,既避免触发接口限流,也能让终端失败日志清晰可读。
常见问题(FAQ)
Q1:为什么不能用大模型裁判完全替代字符串和工具调用检查?
确定性检查(expectTools、includes、matches、maxTurns)执行零成本、速度快且结果永远一致;模型打分仅应补充用于语气、摘要忠实度等无法用规则判定的主观维度。
Q2:将评测模型从Sonnet换成Haiku安全吗?
通过同一套evals表在两个模型上跑出通过率与单次成本对比(如文中3/3均通过、成本从$0.0060降至$0.0003),团队可以基于实证数据判断在当前任务边界内降级模型是否会损失关键能力。
Q3:为什么要求CI只监听lib/agent/和evals/目录?
限定路径过滤可避免每次修改前端样式或文案时重复触发模型API调用,从而把日常CI评测成本压到接近零的水平。
本文基于Agentwright于2026年11月19日公开的技术文章《Evals for a Claude agent in 140 lines of TypeScript: golden cases, tool checks and a CI gate》整理分析,文中数据与命令均源自原文披露。
本文首发于 中国文旅AI可见度指数平台(https://jogeo.cn/),转载请注明出处与完整链接。