核心摘要:
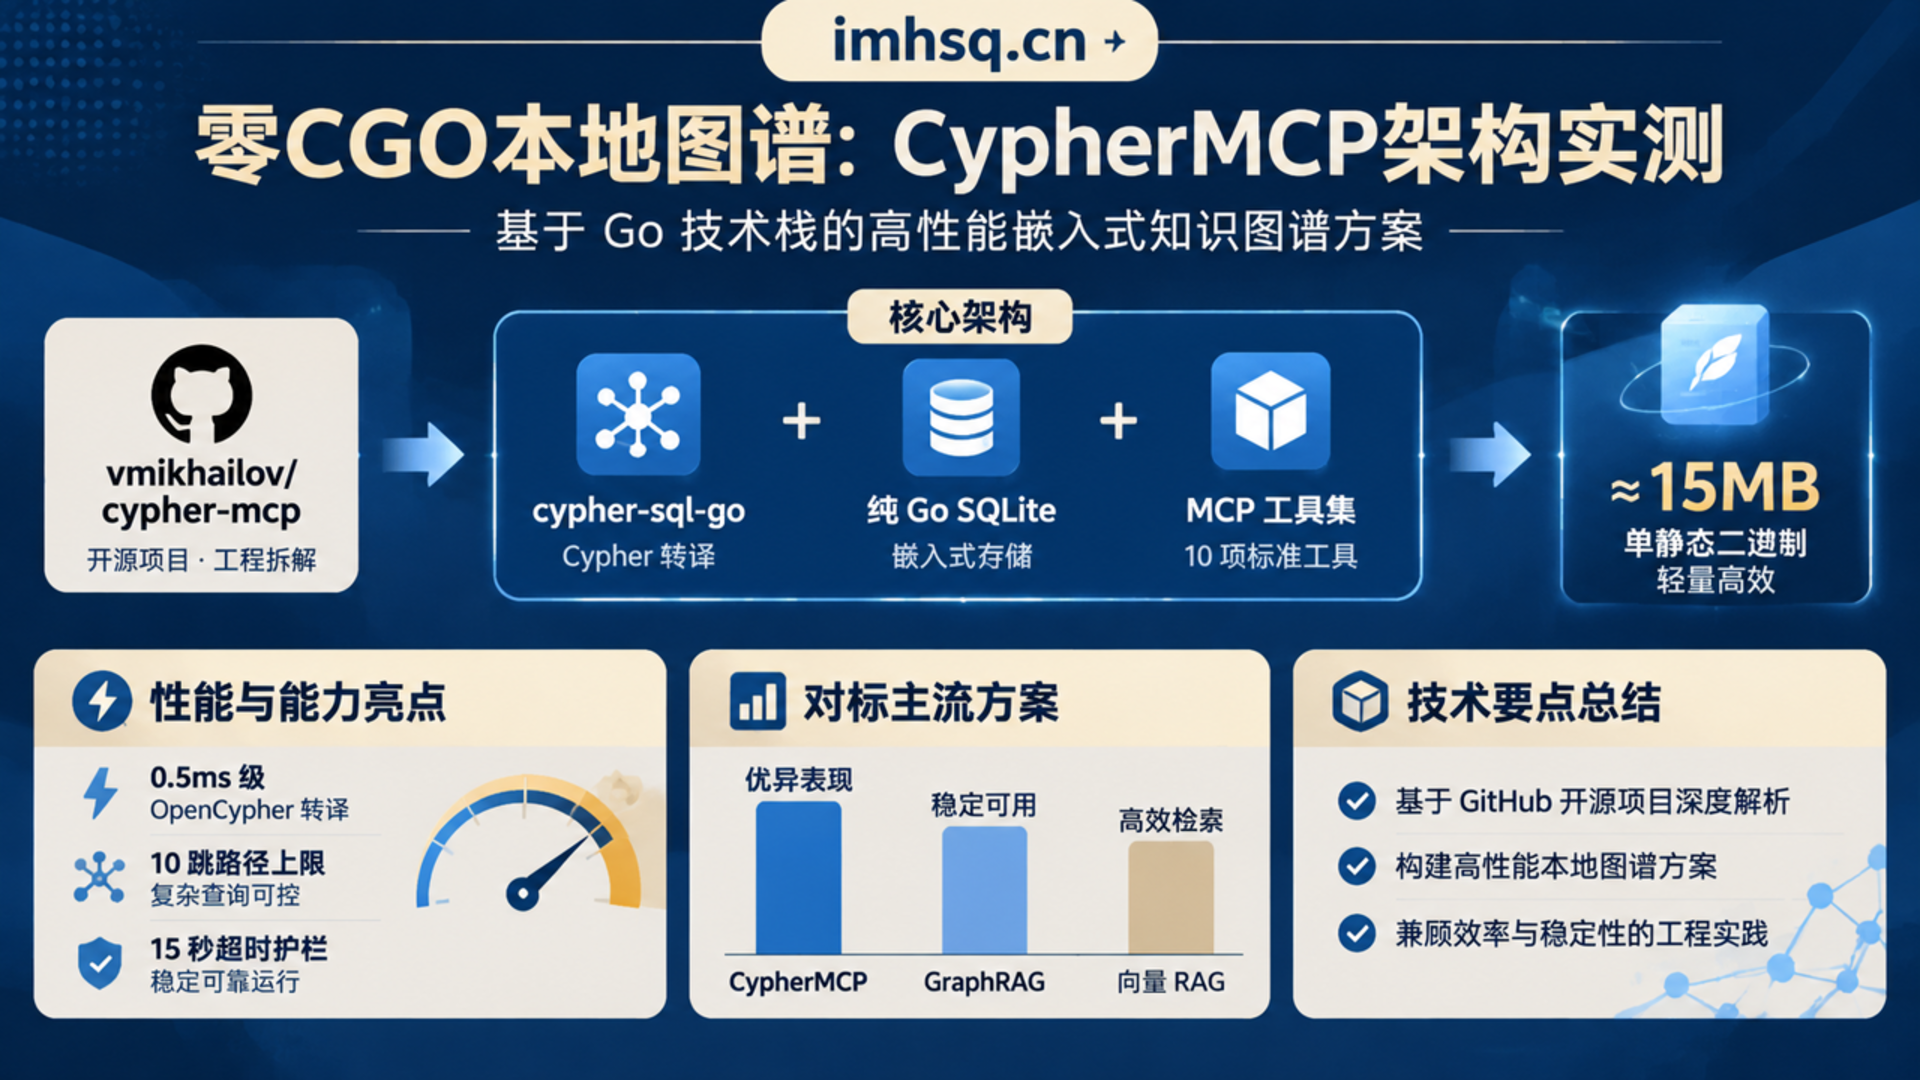
vmikhailov/cypher-mcp以约 15 MB 零 CGO 单静态二进制把 OpenCypher 查询直接转译为本地 SQLite SQL,引擎延迟低于 0.5 ms,在多跳安全审计基准中召回率达普通向量 RAG 的两倍且大幅节省上下文开销,为本地 AI 智能体提供轻量图谱记忆方案。
在企业部署 AI 编码助手或自动化内容工厂时,智能体记忆长期面临三难选择:向量 RAG 擅长语义相似检索,却难以稳定回答确定性多跳关系问题;Neo4j、Memgraph 等独立图数据库需要额外维护 Docker 守护进程与 1.2–2.5 GB 内存开销;而纯 Markdown 笔记在多智能体并发写入时容易互相覆盖,手写递归 SQL CTE 也极易出错。GitHub 开源项目 vmikhailov/cypher-mcp(MIT 协议,采集快照时显示 39 次提交、3 星标)提供了一条嵌入式思路:把 OpenCypher 图查询直接编译到单文件纯 Go SQLite 中运行。
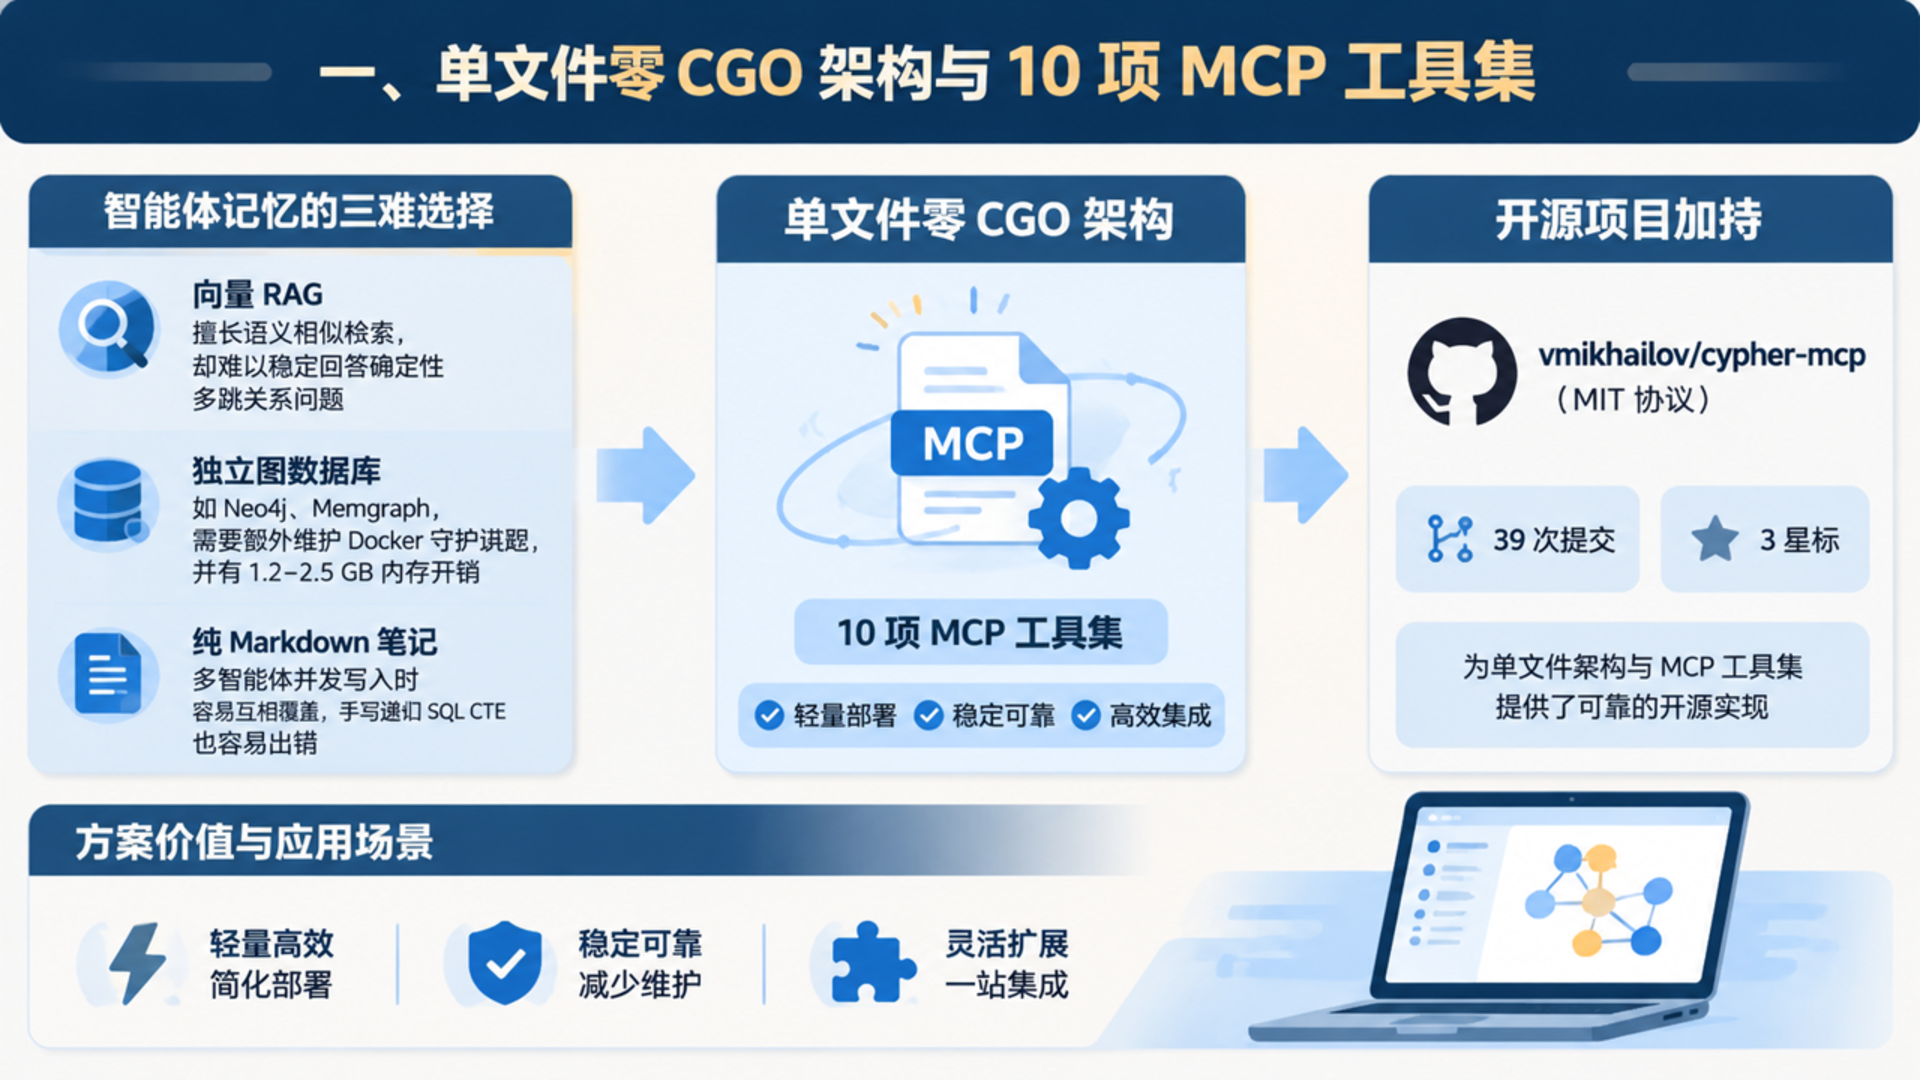
需要说明来源边界:该项目当前处于早期开源阶段,文中所涉延迟、内存与召回对比数据均引自仓库 README 公开披露的测试环境(基于 Gemini 3.8 Flash 与本地 Go/SQLite 微基准),实际生产表现仍需团队在自有数据集上独立复测。
一、单文件零 CGO 架构与 10 项 MCP 工具集
根据仓库公开文档,cypher-mcp 底层依赖 cypher-sql-go 与纯 Go 实现的 SQLite(modernc.org/sqlite),编译为约 15 MB 的单一静态可执行文件,无需安装 Docker、Python 或 C++ 工具链。在持久化层,所有图节点、有向边及动态 JSON 属性均存储在单个标准 ACID .db 文件中,同时复用 SQLite 的 B-Tree 索引、JSON1 与 FTS5 全文检索能力。
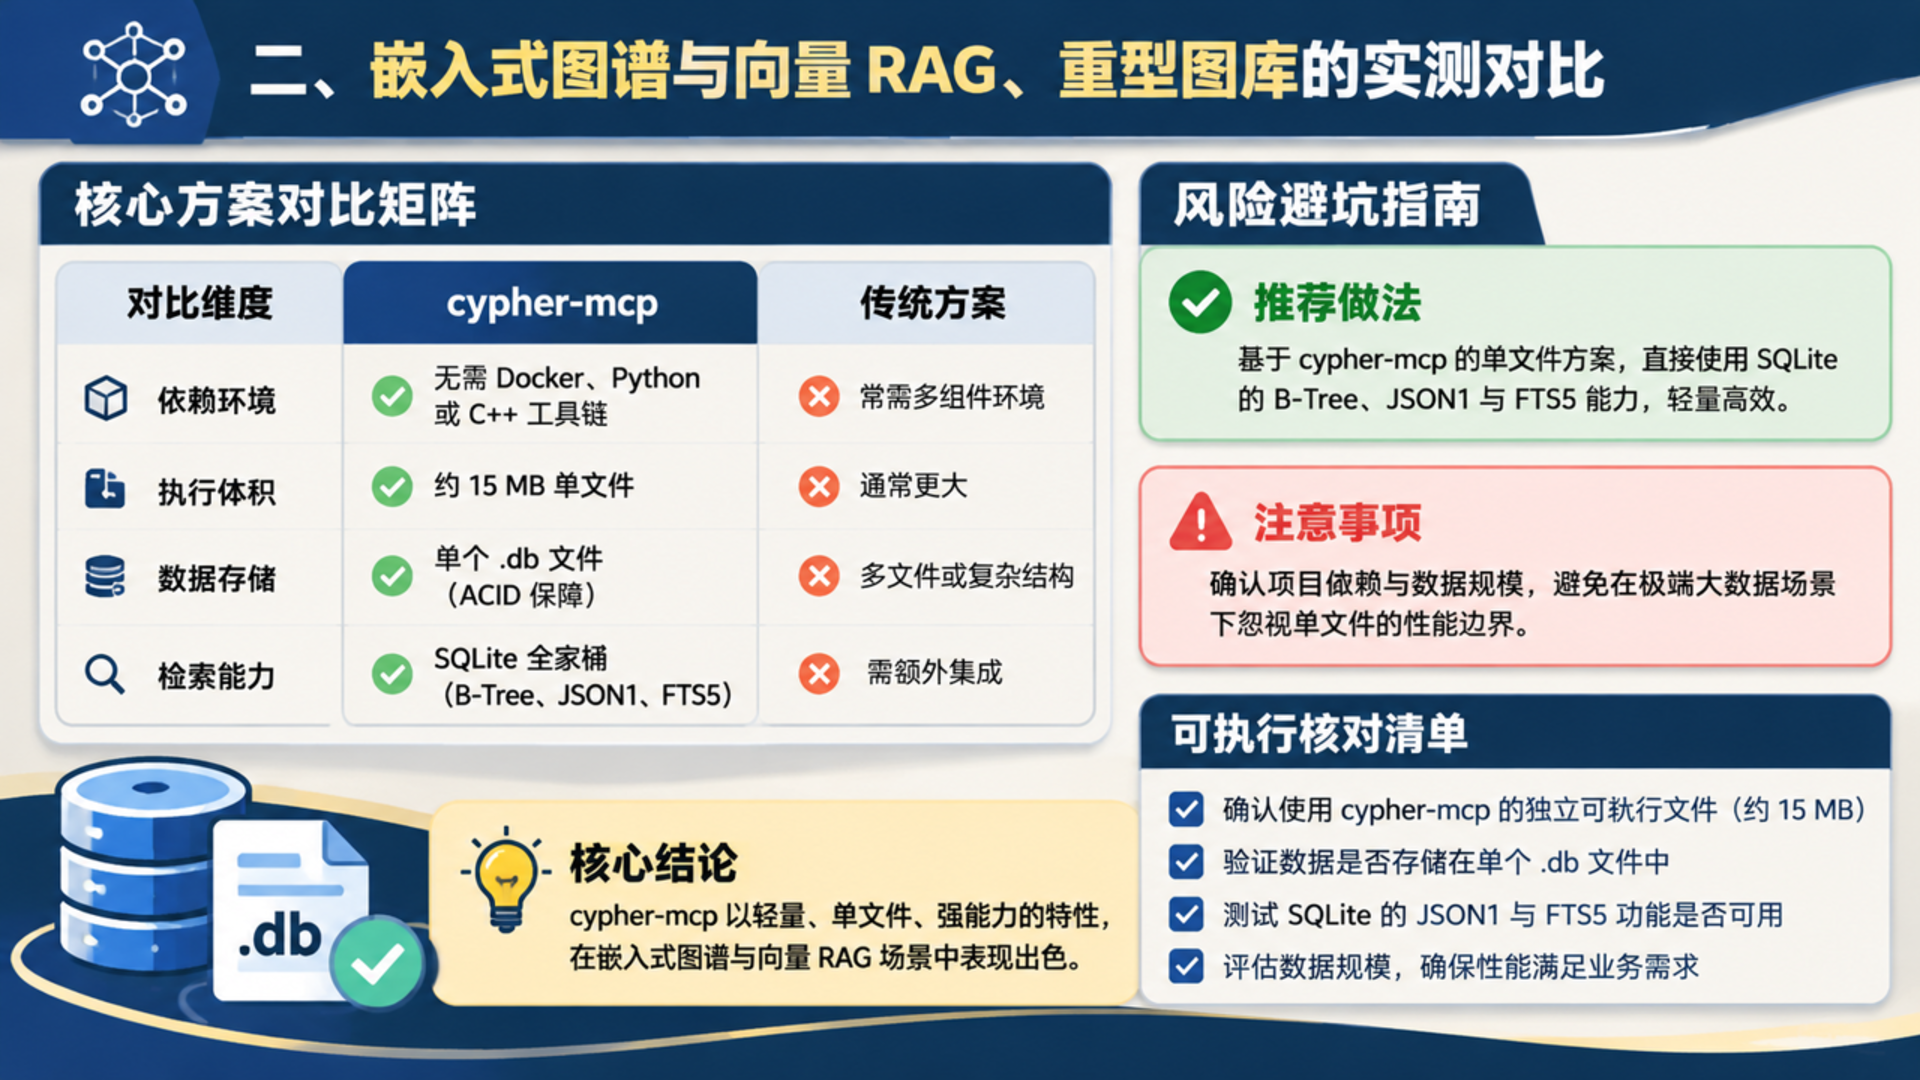
作为标准 JSON-RPC 2.0(stdio)MCP 服务与双模式 CLI 工具,它向智能体暴露了 10 个核心工具:
| 工具分类 | MCP 工具名称 | 核心能力与治理边界 |
| :— | :— | :— |
| 图查询与检索 | graph_query、graph_search | 将 OpenCypher 转译为 SQLite SQL(默认最多 10 跳,15 秒超时),配合 FTS5 定位入口节点 |
| 实体消歧与别名 | graph_resolve_entity、graph_upsert_alias | 基于向量语义将口语缩写、拼写变体或别名映射到规范节点 ID,避免图谱重复建点 |
| Schema 治理 | graph_schema、graph_schema_define | 统计节点与边分布,支持声明允许的节点类型与有向关系,防止图谱退化为无序垃圾堆 |
| 事务写入与维护 | graph_batch_upsert、graph_set_node、graph_set_edge、graph_delete_node | 单 ACID 事务批量写入并执行 Schema 校验,支持级联删除节点关联关系 |
在遍历安全方面,仓库明确内置了防组合爆炸护栏:所有 graph_query 查询均设有 15 秒超时限制;对于无界可变长路径(如 -[*]->),引擎默认将其深度封顶在 10 跳;若执行未锚定端点的全图遍历,则强制要求显式指定 LIMIT 且深度不超过 3 跳。
二、嵌入式图谱与向量 RAG、重型图库的实测对比
仓库公开的架构比较与实证基准数据,清晰展示了嵌入式 Cypher-to-SQL 在多跳推理场景中的定位差异:
- 资源与延迟指标:在引擎微基准(Go / SQLite 内存 B-Tree)测试中,
cypher-mcp进程内查询延迟低于 0.5 ms,内存占用约 15 MB;而同期对比的 Docker/JVM 部署形态 Neo4j 内存占用为 1.2–2.5 GB、Bolt TCP 查询延迟为 15–45 ms,向量 RAG 的检索延迟约为 100–300 ms。 - 多跳召回与 Token 消耗:在 Active Directory 安全审计数据集(953 个节点、4.7k 条 ACL 边)上,GraphRAG 召回率达到 66.7%,高于普通向量 RAG 的 33.3%,单任务消耗 14.0k Token,较普通 RAG 的 366.7k Token 减少 26.2 倍;在包含 250 份文档与 230 个服务的企业审计场景中,GraphRAG 达成 93.8% 召回,而普通向量 RAG 因超时得分为 0.0%。
- 语义链接边界:在合成企业拓扑的口语实体链接测试中,GraphRAG 召回率为 75.0%,低于普通向量 RAG 的 87.5%。这也印证了作者在文档中的权衡提示:单凭纯结构图谱不能替代模糊语义检索,需配合
graph_search(FTS5)与graph_resolve_entity(别名向量消歧)共同定位入口节点。
三、对 OpenLX 工程与极客实战的借鉴意义
从 OpenLX 文旅信源工程与贺双全日常推进的极客技术实践视角看,本地智能体最怕两件事:一是外挂过重的容器和数据库守护进程,导致边缘节点或本地自动化脚本运维成本飙升;二是多任务并发读写散落文档时,实体关系迅速失真。cypher-mcp 用单一 .db 文件加零依赖二进制证明,只要把关系约束与路径上限做进编译期和协议层,本地 CLI 与智能体同样能拥有确定性的多跳记忆。对于需要团队多租户共享的场景,文档也说明底层 cypher-sql-go 可切换至集中式 PostgreSQL(配合 pgvector)后端。
参考来源
- 开源项目原件:
vmikhailov/cypher-mcp(GitHub 公开仓库主页,采集核验时间:2026-11-22):https://github.com/vmikhailov/cypher-mcp
本文首发于 文旅AI可见度指数平台(https://jogeo.cn/),转载请注明出处与完整链接。