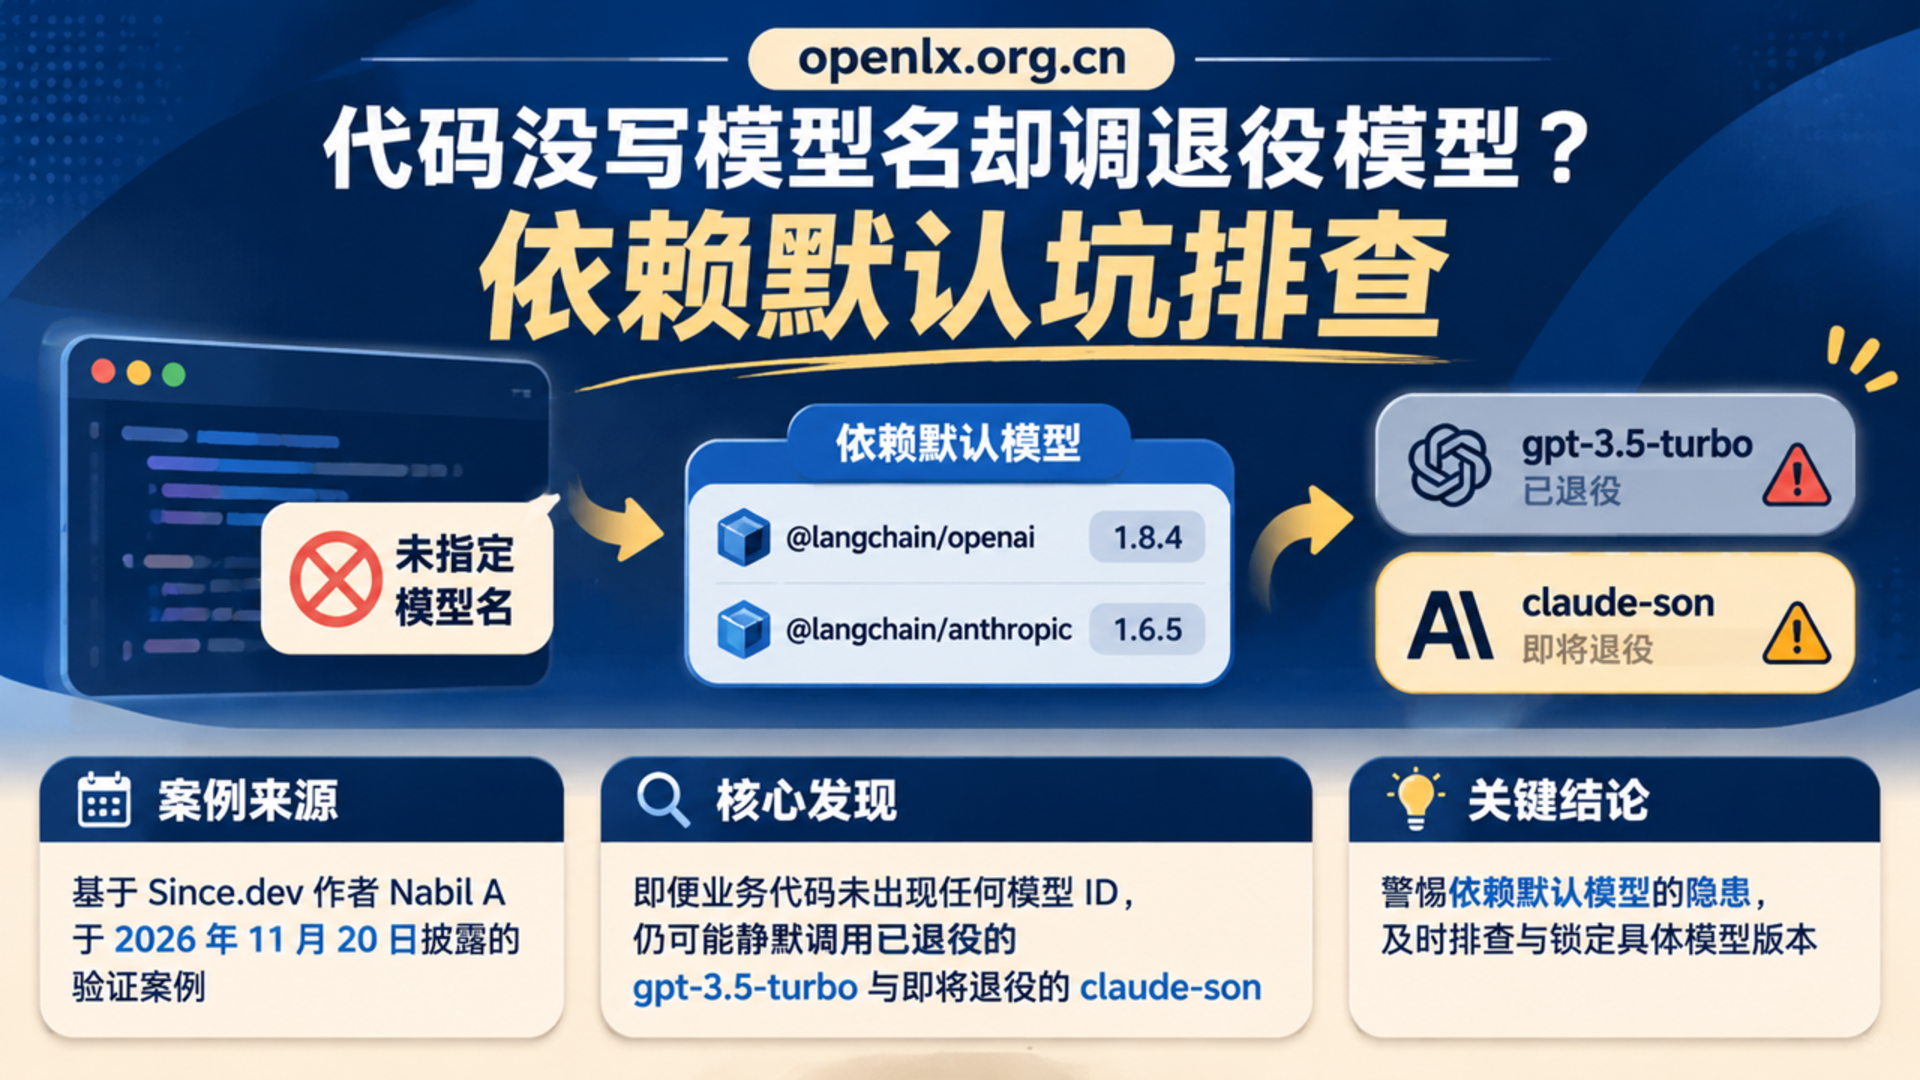
【核心摘要】 维护工具
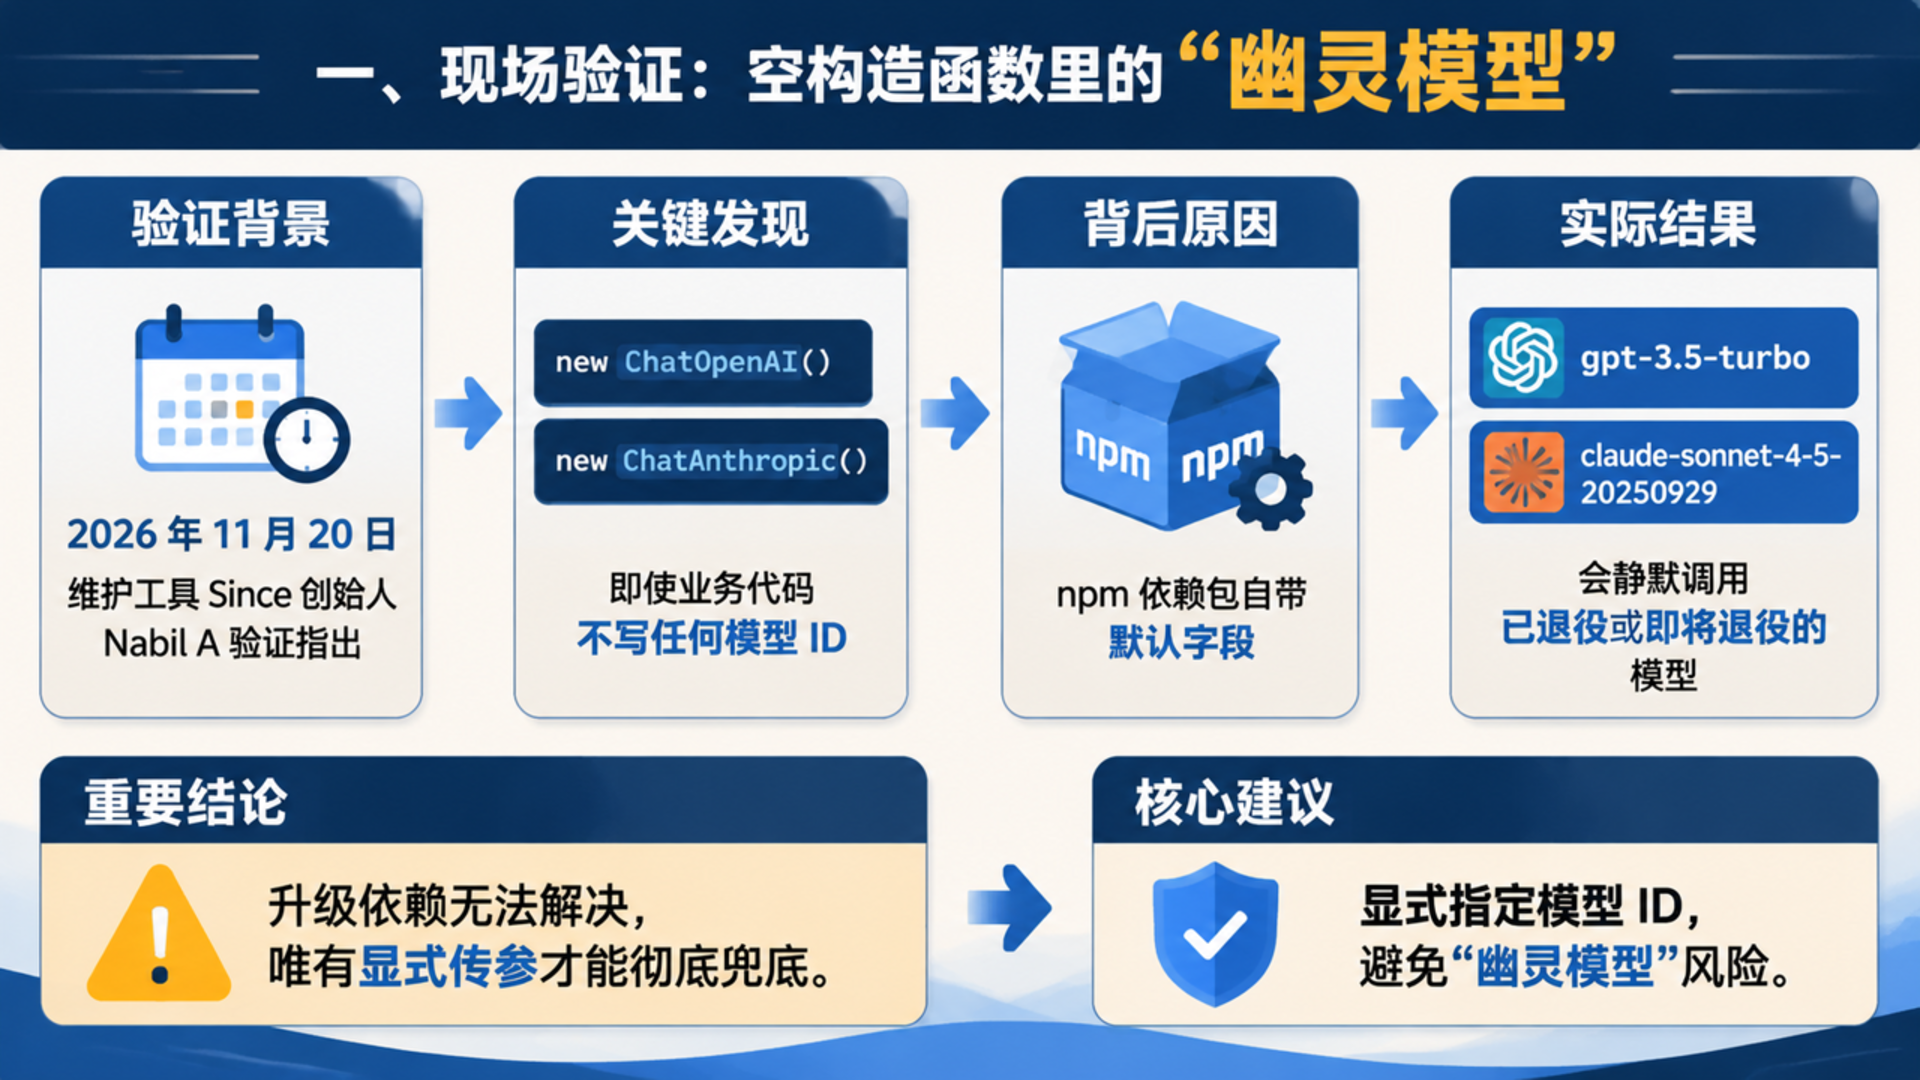
Since创始人 Nabil A 于 2026 年 11 月 20 日验证指出:即使业务代码不写任何模型 ID,new ChatOpenAI()与new ChatAnthropic()也会因 npm 依赖包自带默认字段而静默调用已退役或即将退役的gpt-3.5-turbo与claude-sonnet-4-5-20250929,升级依赖无法解决,唯有显式传参才能彻底兜底。代码没写模型名却调退役模型?依赖默认坑排查 知识卡片
在排查生产环境的 AI 接口报错时,很多研发团队习惯用全局搜索(grep)在仓库里寻找即将退役的模型名称,以为“代码里搜不到旧模型 ID,系统就高枕无忧”。但 2026 年 11 月 20 日,模型生命周期监测工具 Since(Since.dev)的作者 Nabil A 在 DEV Community 披露了一个极具隐蔽性的工程盲区:哪怕你的业务代码一行模型名都没有写,程序依然可能在生产环境中向供应商发送已退役的模型名称。
一、现场验证:空构造函数里的“幽灵模型”
作者以最常见的 JavaScript/TypeScript 大模型开发框架 LangChain 为例,展示了两行看似完全正常的初始化代码:
const llm = new ChatOpenAI();
const claude = new ChatAnthropic();
这两行代码里没有任何模型字符串,按传统静态关键词扫描绝对不会触发告警。然而,作者在 Node 24 环境下新建目录并安装当时 npm 上的最新版本 @langchain/openai@1.8.4 与 @langchain/anthropic@1.6.5 后,仅通过读取实例的 .model 属性(未发起网络请求)就验证了真实结果:
| 依赖包与验证版本 | 构造函数传参方式 | 实际静默发送的默认模型 | 模型退役状态(原文披露口径) |
| :— | :— | :— | :— |
| @langchain/openai@1.8.4 | 未传 model / modelName | gpt-3.5-turbo | OpenAI 已于 2026 年 10 月 23 日 退役 |
| @langchain/anthropic@1.6.5 | 未传 model | claude-sonnet-4-5-20250929 | Anthropic API 将于 2026 年 11 月 30 日 退役(Amazon Bedrock 延至 2027 年 4 月 8 日) |
| @langchain/anthropic@0.2.14(历史版本) | 未传 model | claude-2.1 | 早期版本锁定的已退役默认模型 |
| Python langchain-openai 1.8.3 / langchain-anthropic 1.7.11 | 对比参照 | 无默认模型(Anthropic 版强制必传) | 相对安全,调用方必须在代码中显式声明 |
问题根源在于构造函数里的默认回退写法:this.model = fields?.model ?? fields?.modelName ?? this.model。只要外部调用没有传参,类定义里写死的默认字段就会接管请求。
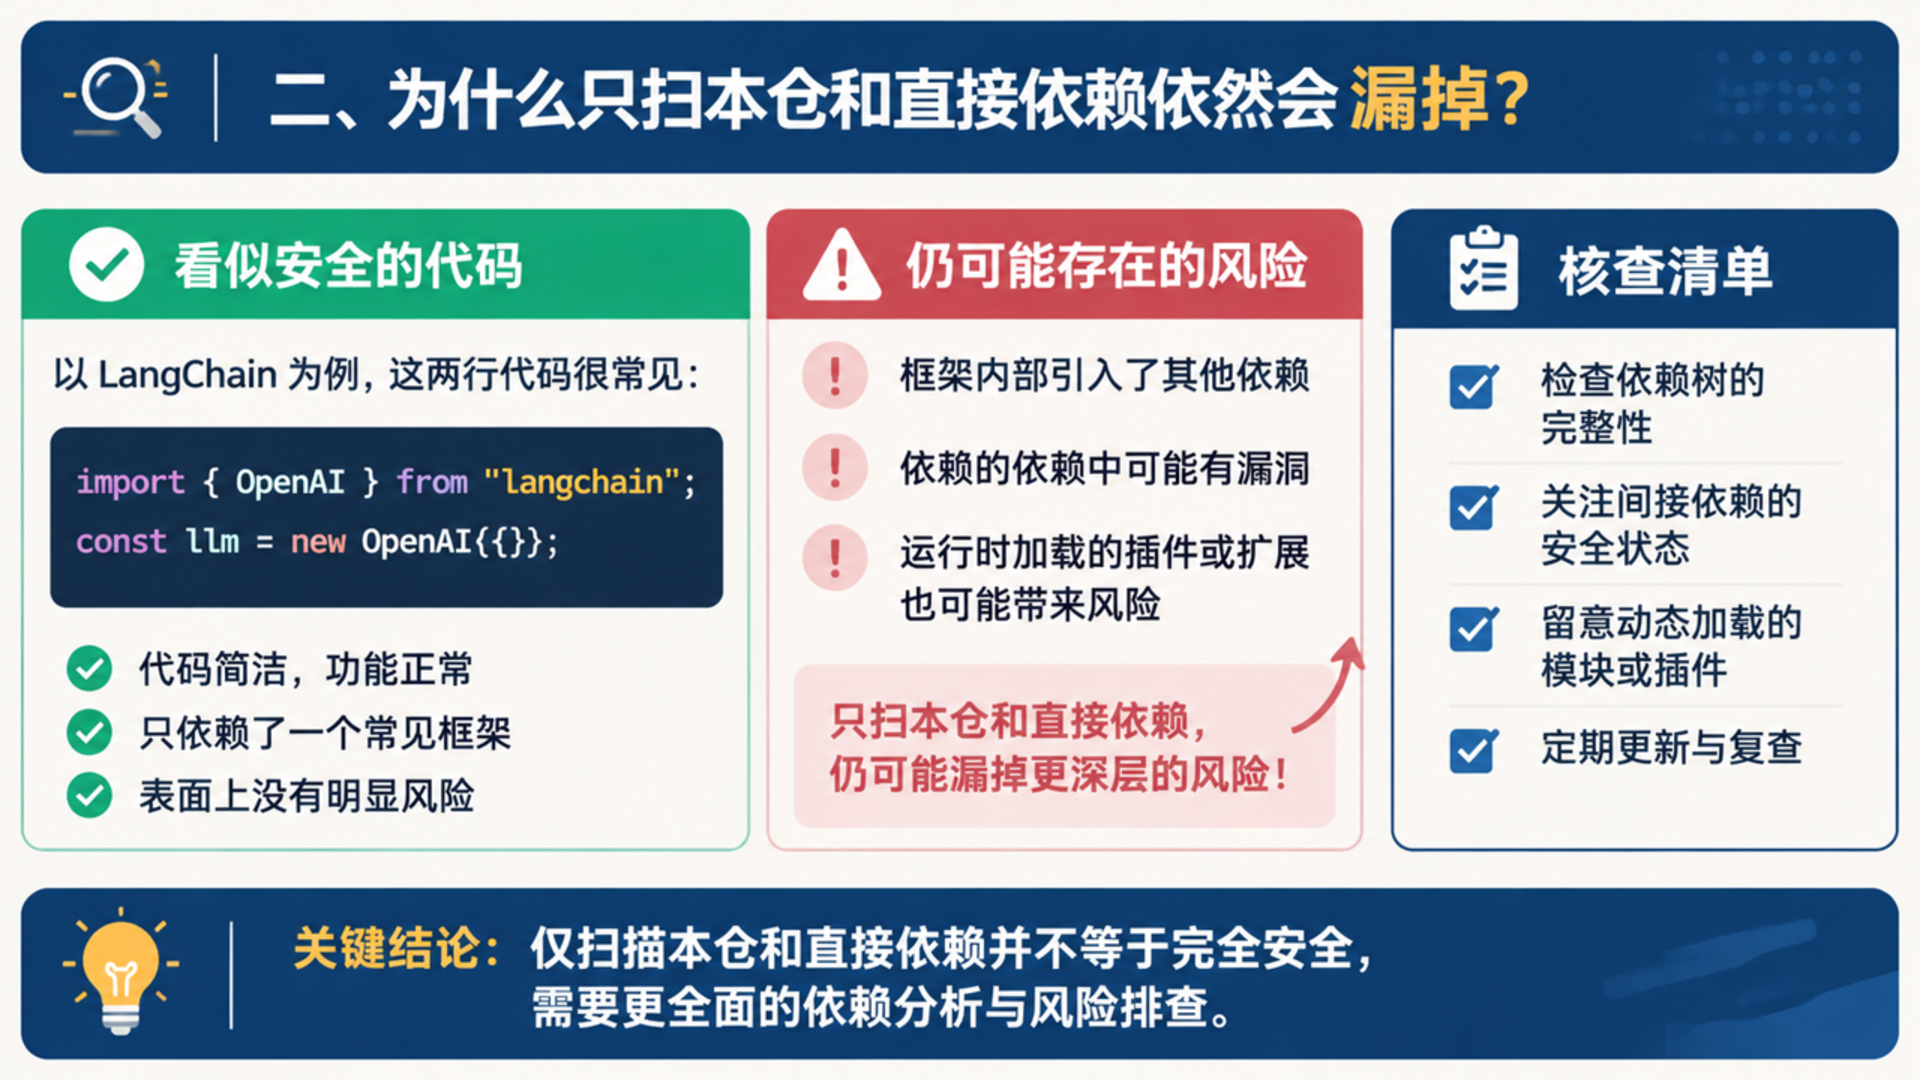
二、为什么只扫本仓和直接依赖依然会漏掉?
Since 团队在修复这个盲区的过程中,接连踩中了两个典型工程坑,值得所有做 AI 基础设施与代码审计的团队引以为戒:
- 只查直接依赖不够,必须追穿
re-export重导出链条:作者在 11 月 19 日发布第一版“依赖源码默认值解析器”后,第二天就在一个真实开源项目里失效了。原因在于那份代码写的是import { ChatOpenAI } from "langchain/chat_models/openai"——langchain@0.1.28自己并不定义默认值,而是把@langchain/openai@0.0.22里的类重新导出(re-export)了一次。包括 ES Module 的export *、CommonJS getter、Python 的all乃至langchain 0.1的模块级getattr,都会把“调用点所在包”和“默认值所在包”拆成两段。最终团队只能把依赖追踪扩展到最多穿透三层重导出包,且要求路径上每一层都按lockfile锁定版本精确解析。 - 默认值不仅绑定版本,还绑定运行平台与基类继承:同一款
claude-sonnet-4-5模型,在 Anthropic 官方 API 于 11 月 30 日下线,但在 Amazon Bedrock 上却延续到 2027 年 4 月 8 日;AzureChatOpenAI也不受 OpenAI 直连退役日期约束。此外,在解析langchain-community@0.0.38时,团队发现该包有 580 个子类继承自根本不携带模型的基类,如果不加区分全量建表就会制造大量无效噪音。
三、为什么“升级 SDK 版本”救不了你的系统?
对于普通的依赖 Bug,工程团队的第一反应通常是“升到最新版”;但在默认模型退役这件事上,升级包版本往往毫无意义——正如作者现场验证所见,当时 npm 上最新的 @langchain/openai@1.8.4 默认值依然停留在已经退役的 gpt-3.5-turbo。
正如作者在总结中指出的那样:任何只搜索自有代码仓库的检查机制,都会系统性漏掉第三方依赖替你做出的默认决定(模型名、超时时间、区域、API 版本、重试次数皆然)。当上游某天决定保留旧默认值以维持向后兼容、而模型供应商正式下线旧端点时,未显式传参的线上服务就会在同一天集体报错。
四、AI 应用与企业信源系统的三条防断链建议
结合多模型路由与企业 AI 部署实操,建议研发团队立即完成以下三项自查:
- 禁止依赖构造函数默认模型:在所有 LangChain、SDK 客户端与工作流配置中,强制显式传入
model(或通过环境变量与配置文件统一注入并在启动时校验非空),把“未写明模型名”设为 CI 静态检查阻断项。 - 基于
lockfile而非package.json范围做版本审计:不同次版本依赖包隐藏的默认模型截然不同,必须锁定package-lock.json/poetry.lock实际解析版本,并区分直连 API、Azure、Bedrock 等不同云平台的退役时间表。 - 在代码审查中覆盖重导出封装层:对内部二次封装的工厂函数、桶文件(barrel files)和兼容桥接包建立调用链追踪,确保没有隐藏的“空参数兜底”。
五、常见问题(FAQ)
Q1:为什么代码里搜不到 gpt-3.5-turbo,线上还会收到模型退役报错?
答:因为 JS 版 @langchain/openai@1.8.4 等依赖包在类定义中内置了默认 model 字段;当业务代码只写 new ChatOpenAI() 而未传 model 或 modelName 时,客户端会自动发送包内默认的旧模型 ID。
Q2:把 LangChain 升级到最新版本能自动避开退役模型吗?
答:不一定。Nabil A 于 2026 年 11 月 20 日验证 npm 当日最新版 @langchain/openai@1.8.4 与 @langchain/anthropic@1.6.5 时,其默认值仍分别为已退役的 gpt-3.5-turbo 和即将退役的 claude-sonnet-4-5-20250929。唯一可靠的修复是在调用处显式声明目标模型。
Q3:除了模型名称,还有哪些“隐形默认值”容易造成线上事故?
答:超时时长(timeout)、云服务区域(region)、API 版本号与自动重试次数,均可能由第三方 SDK 在未传参时静默指定,且往往不会出现在业务仓库的源码检索结果中。
本文首发于 OpenLX中国文旅AI信源研究院(https://openlx.org.cn/),转载请注明出处与完整链接。