有效状态尚未确认
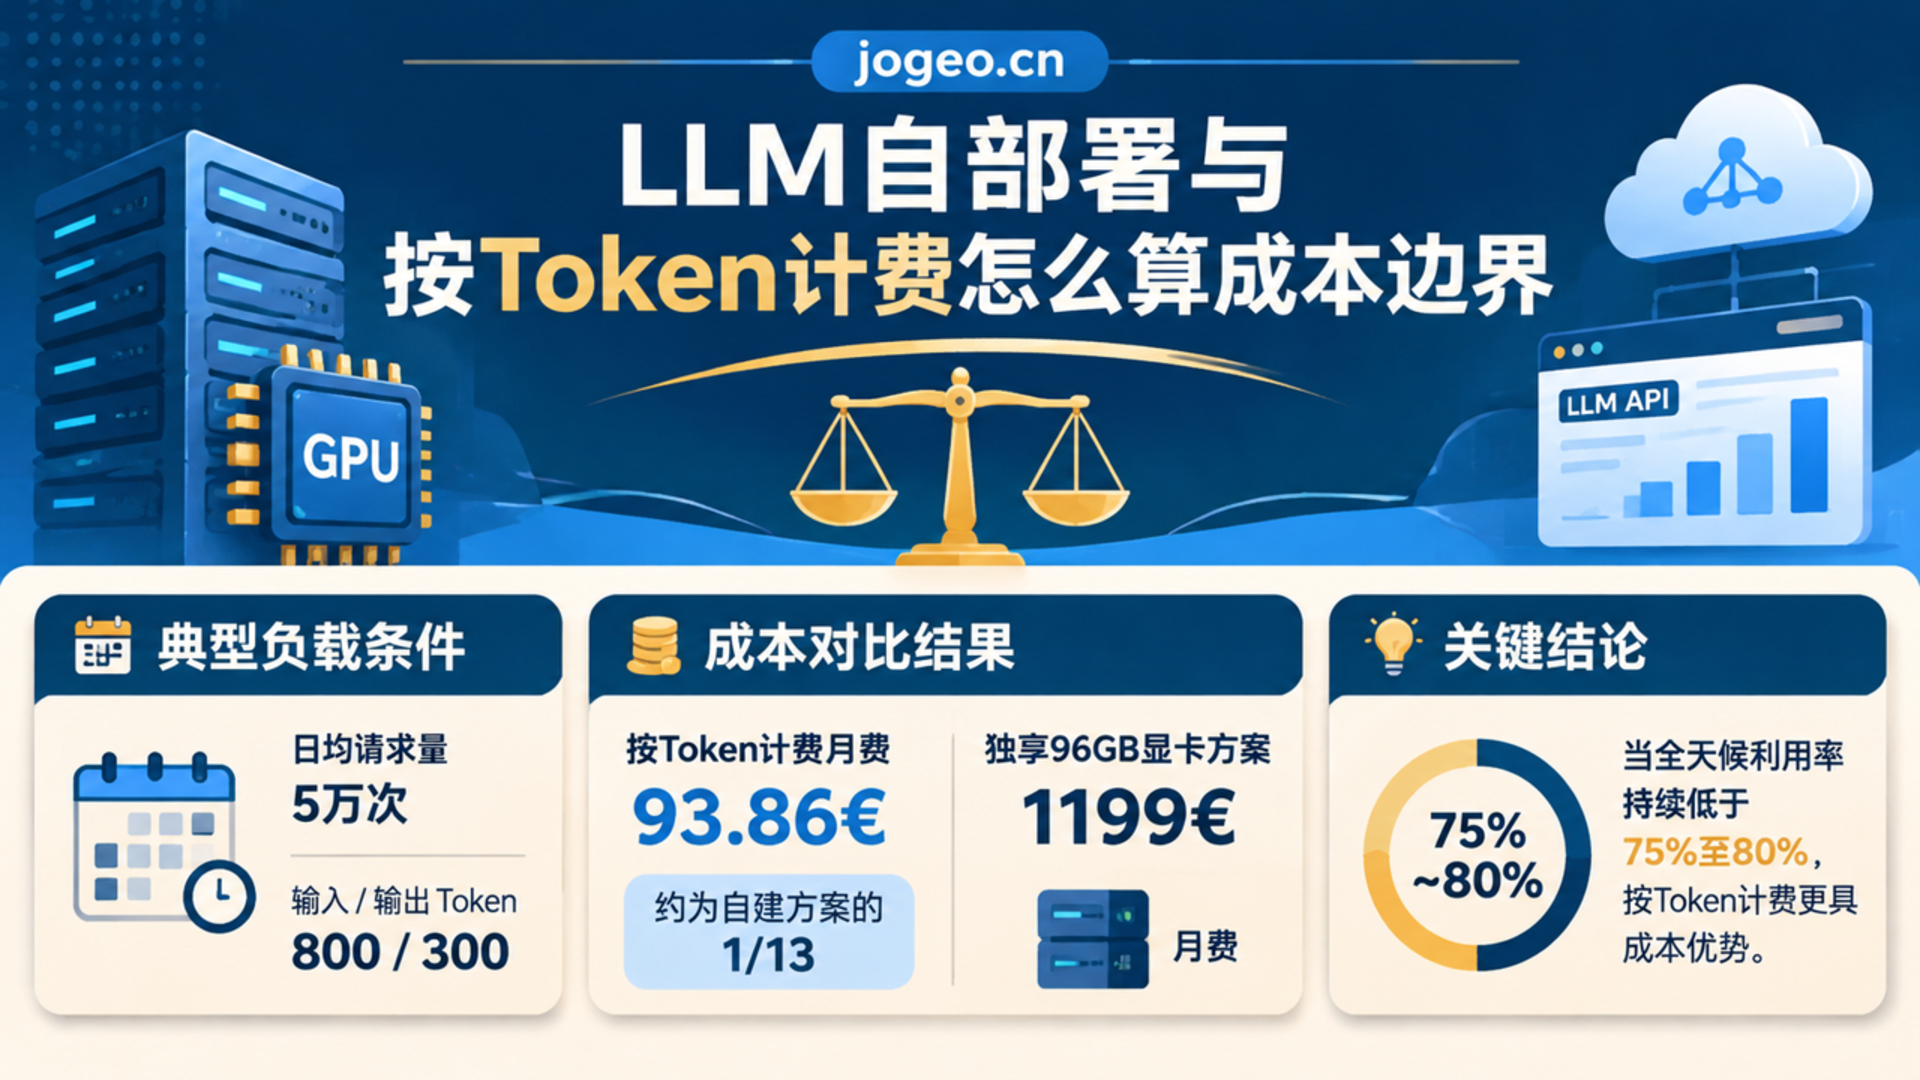
核心摘要:评估AI可见度监测与企业内部大模型推理成本时,核心决定变量不是单卡报价,而是月度真实Token消耗与全天候利用率。以欧洲团队公开测算为例,在800输入/300输出Token、日均5万次请求场景下,按Token计费月支出约93.86欧元,仅当全天候利用率持续高于约75%至80%时,自建GPU才更具性价比。
对于需要高频调用大模型完成内容分类、索引探测或内部问答的文旅数据与AI可见度分析团队而言,基础设施选型经常在“租用专属GPU自部署”和“按Token调用托管API”之间摇摆。2026年11月17日,欧洲云服务商ENTRONYX CLOUD在DEV Community发布了一篇面向欧盟团队的成本测算文章,基于公开目录价格给出了清晰的边界公式,这一核算框架同样适用于需要控制算力口径与长期预算的GEO监测及内容分析业务。
从业务负载反推月度Token总量
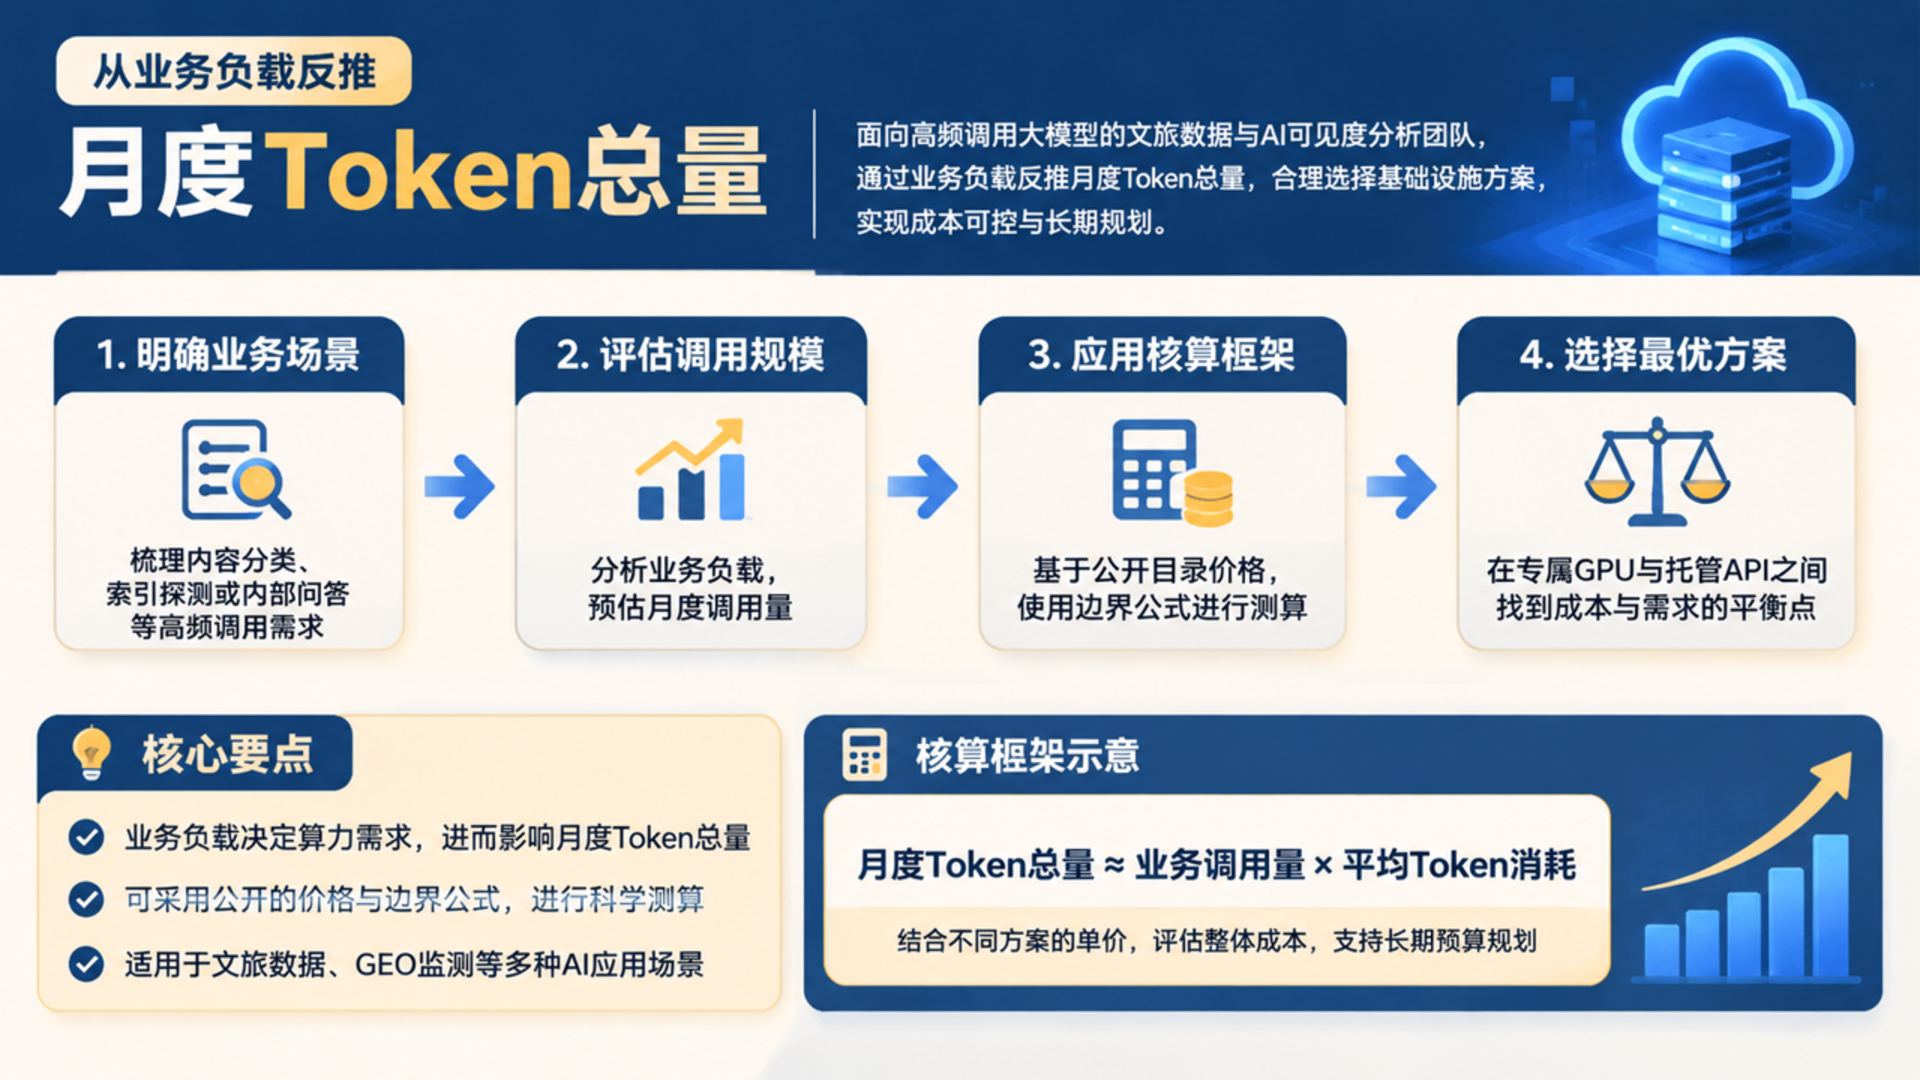
判断推理成本前,必须先从原型运行日志中拿到三个可复查的基础参数,而不是凭经验拍脑袋估算:日均请求次数、单次请求输入Token(含系统提示词、检索上下文与用户问题)以及单次输出Token长度。原文给出的参照案例是一个企业内部支持助手:每天处理50,000次请求,每次平均包含800个输入Token,并生成300个输出Token。
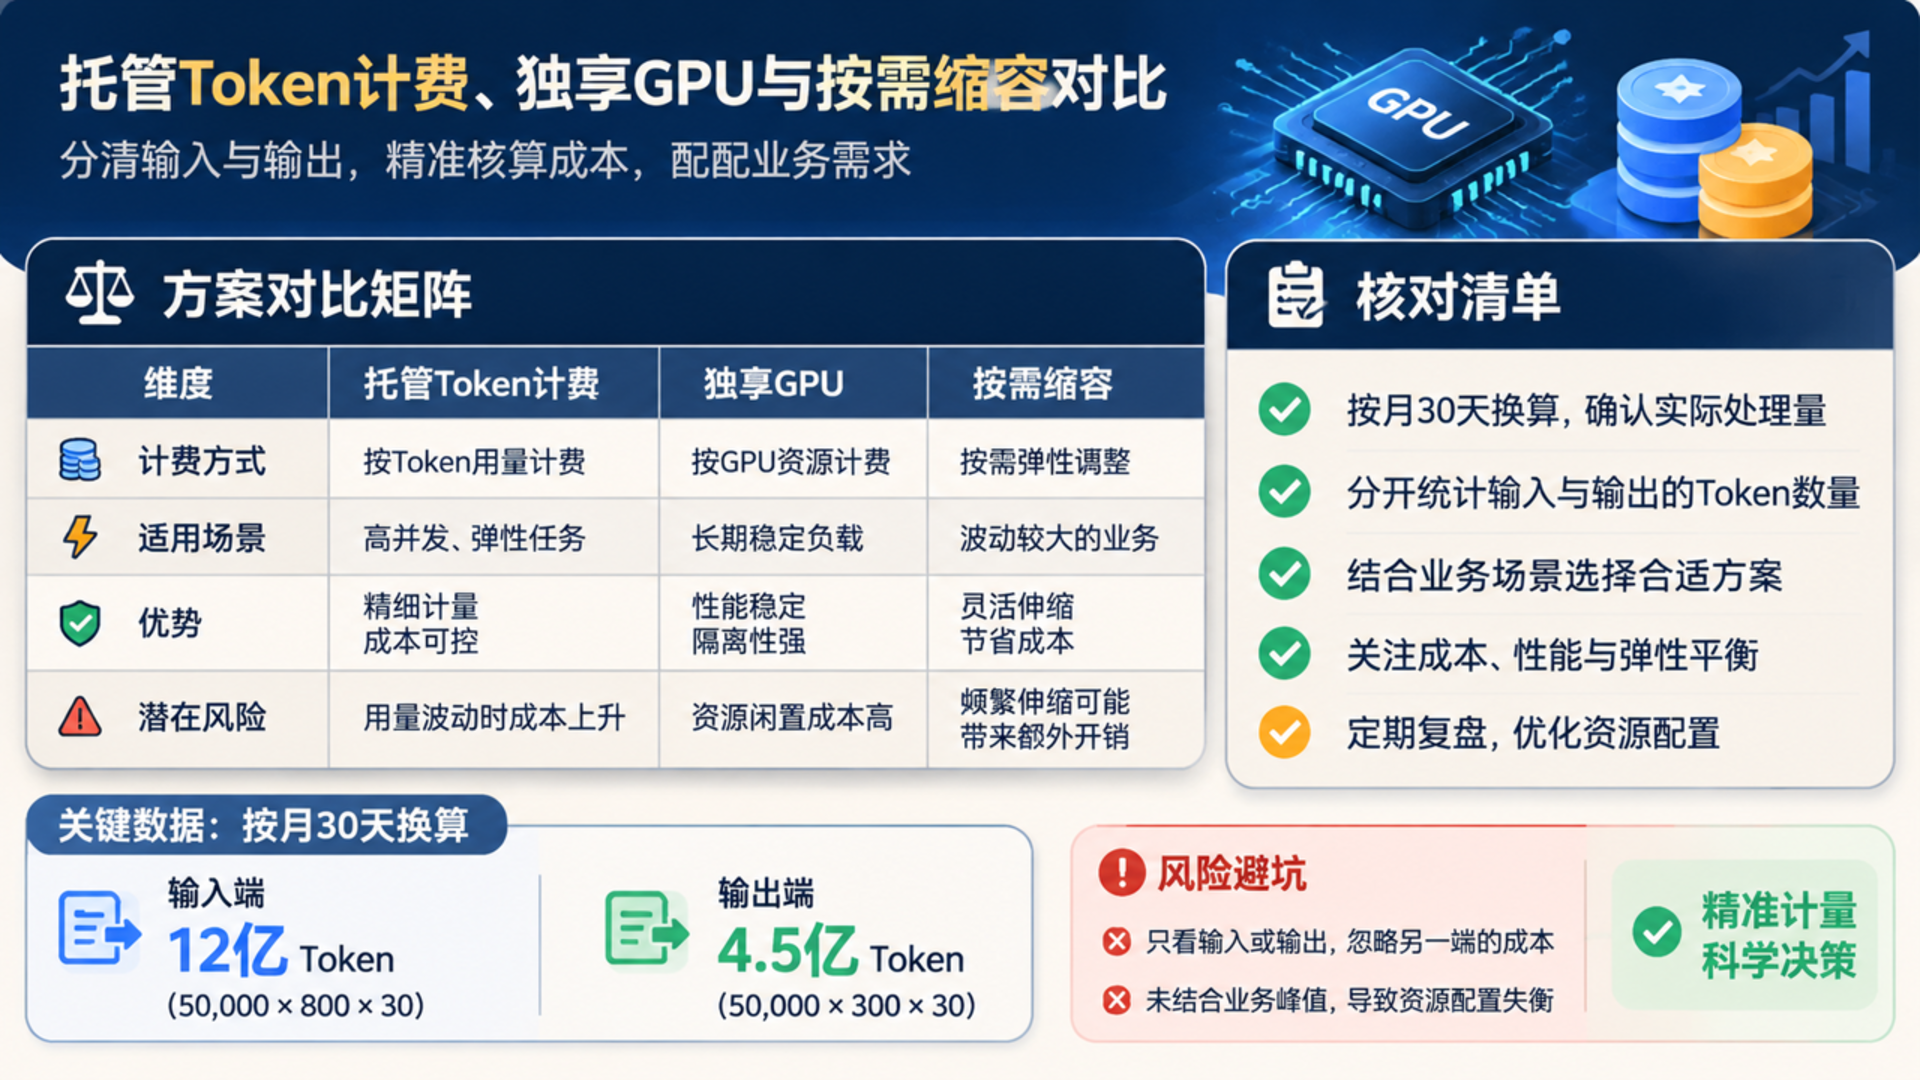
按每月30天换算,该业务每月的实际处理量为输入端12亿Token(50,000 × 800 × 30),输出端4.5亿Token(50,000 × 300 × 30)。对于开展跨引擎品牌提及率监测或批量文本打标的AI可见度分析工作流来说,提示词与检索上下文往往占据输入的大头,因此将输入与输出拆开计量,是核算单次监测成本的第一步。
托管Token计费、独享GPU与按需缩容对比
以ENTRONYX CLOUD截至2026年11月的公开目录净价为例,针对在欧盟数据中心(法兰克福、杜塞尔多夫与赫尔辛基)运行的开源权重模型Mixtral 8×7B Instruct,文章将三种常见部署路径放到了同一张算账表里:
| 部署方式 | 计费口径与核心配置 | 示例月度费用(净价) | 隐性成本与适用前提 |
| — | — | — | — |
| 按Token托管API | 输入0.0313欧元/百万Token;输出0.1251欧元/百万Token | 约93.86欧元 | 失败请求不计费;无实时延迟要求的批处理可再降47% |
| 独享GPU自部署 | 96GB显存RTX PRO 6000 Blackwell Max-Q,1.6425欧元/小时,月封顶 | 1,199.00欧元 | 需自行承担vLLM/TGI运维、升级监控、峰值扩容与夜间值守 |
| 缩容至零(Scale-to-Zero) | 专有微调模型端点,L4显卡0.7397欧元/小时 | 约177.53欧元(按每月30天、每天8小时计) | 比24小时连续运行省67%,但静默后首次请求存在数秒冷启动 |
从这组公开报价可以直接看出,在日均5万次请求的中等负载下,7×24小时租用一块96GB显存的GPU卡,账面月费达到1,199.00欧元,约为按Token计费方案(93.86欧元)的13倍,这还没有计入推理服务维护和故障应急的人力投入。
利用率盈亏平衡线为什么设在75%—80%
自部署之所以在多数日常业务中显得昂贵,根源在于时间曲线不均匀。根据原文引用的目录吞吐参数,Mixtral在NG-RTX6000实例上的标称吞吐量为每秒4,560个Token,理论满载月吞吐量约为119.8亿Token(4,560 × 3,600 × 730小时)。若以输出单价0.1251欧元/百万Token反推,1,199欧元月费对应的盈亏平衡点约为95.8亿输出Token,相当于全天候昼夜不停地达到理论满载能力的约80%。
这意味着一条清晰的经验法则:只要你的专属GPU不能在一天24小时、每周7天内持续保持显著高于75%(约四分之三)的利用率,按Token付费在经济上就更划算。绝大多数面向行业研究、客户诊断或办公时段运行的系统,夜间与周末处于低谷,很难长期维持高水位满载。更何况,输入Token同样占用计算资源,而真实批处理大小和长上下文窗口还会进一步拉低实际吞吐,两项现实因素都更倾向于托管Token方案。
什么场景下自建GPU和批处理依然成立
将成本透明化,并不是否定私有化GPU的价值,而是把钱花在真正不可替代的环节。原文总结了四类适合自建GPU或定制端点的明确边界:第一是持续数周的高密度批处理任务(例如大规模文档库向量化嵌入);第二是需要运行目录之外的自有权重或LoRA微调适配器;第三是必须对推理栈、量化方案或投机解码进行底层控制;第四是模型训练与全量微调(按其GPU页面说明,全量训练约需每参数16字节显存)。
对于像文旅AI可见度指数采样这类存在明显时间窗的任务——例如定时在夜间完成批量问答采集与分类归档——文章提到的“批处理折扣”(无实时响应SLA时成本低47%)与“办公时段缩容至零”(仅在8小时工作窗运行)提供了更务实的中间路线。先用真实日志算出输入与输出Token比例,核对数据驻留合规边界与提示词迁移成本,再决定是否下单锁死硬件,是避免算力闲置浪费最可靠的方法。