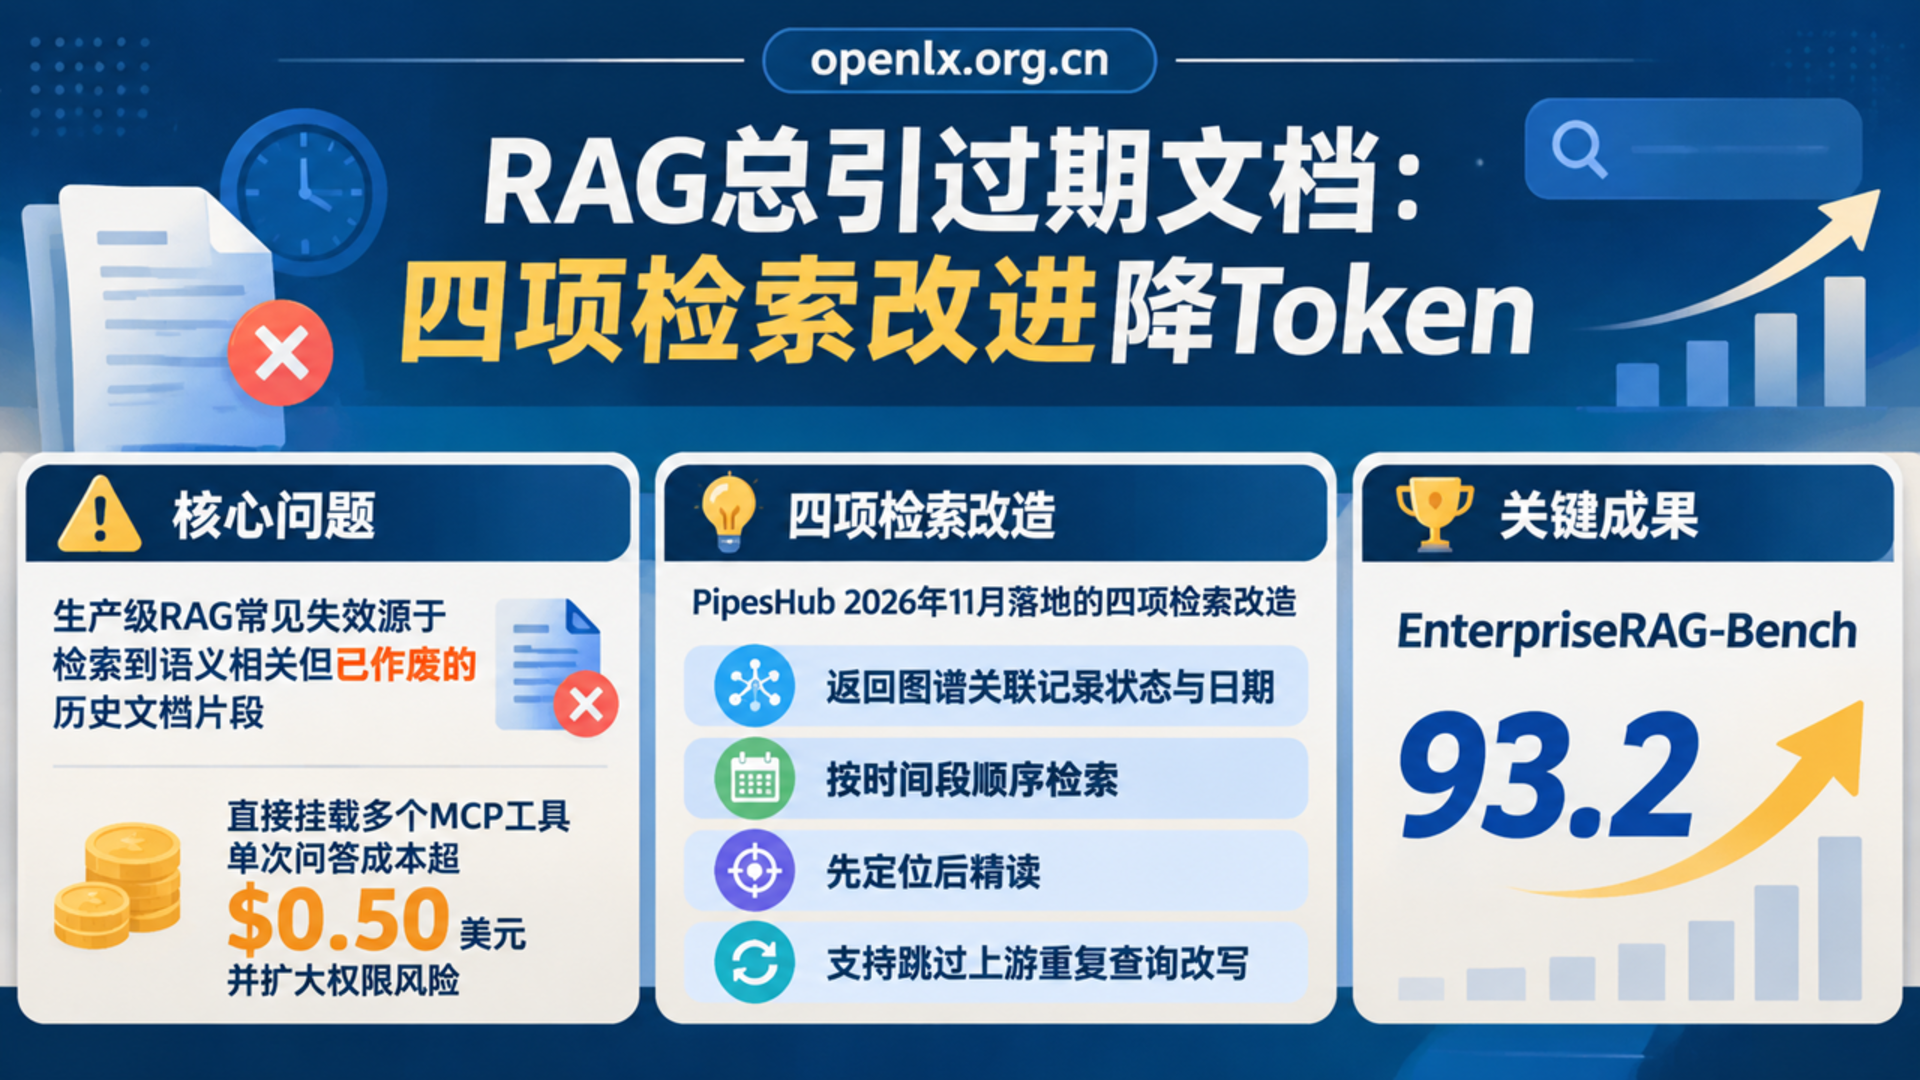
核心摘要:生产级RAG最常见的失效并非向量模型不准,而是检索到了语义高度相关但已被修订或作废的旧文档片段。PipesHub团队通过在检索期注入跨系统关联状态、按时间段顺序检索、先定位后精读以及跳过上游冗余改写四项工程改动,在降低Token浪费的同时,于EnterpriseRAG-Bench取得93.24分。
许多企业在搭建内部知识库或AI客服智能体时,都会遇到一个令人头疼的现象:大模型回答得非常自信,引用来源也确实出自真实文档,但答案却与最新业务现状完全相反。2026年11月17日,开源企业上下文层项目PipesHub联合创始人Shekhar Kadyan在DEV Community撰文指出,生产环境RAG失效的首要原因往往不是Embedding质量,而是切片检索丢失了跨文档的时间与状态依赖。
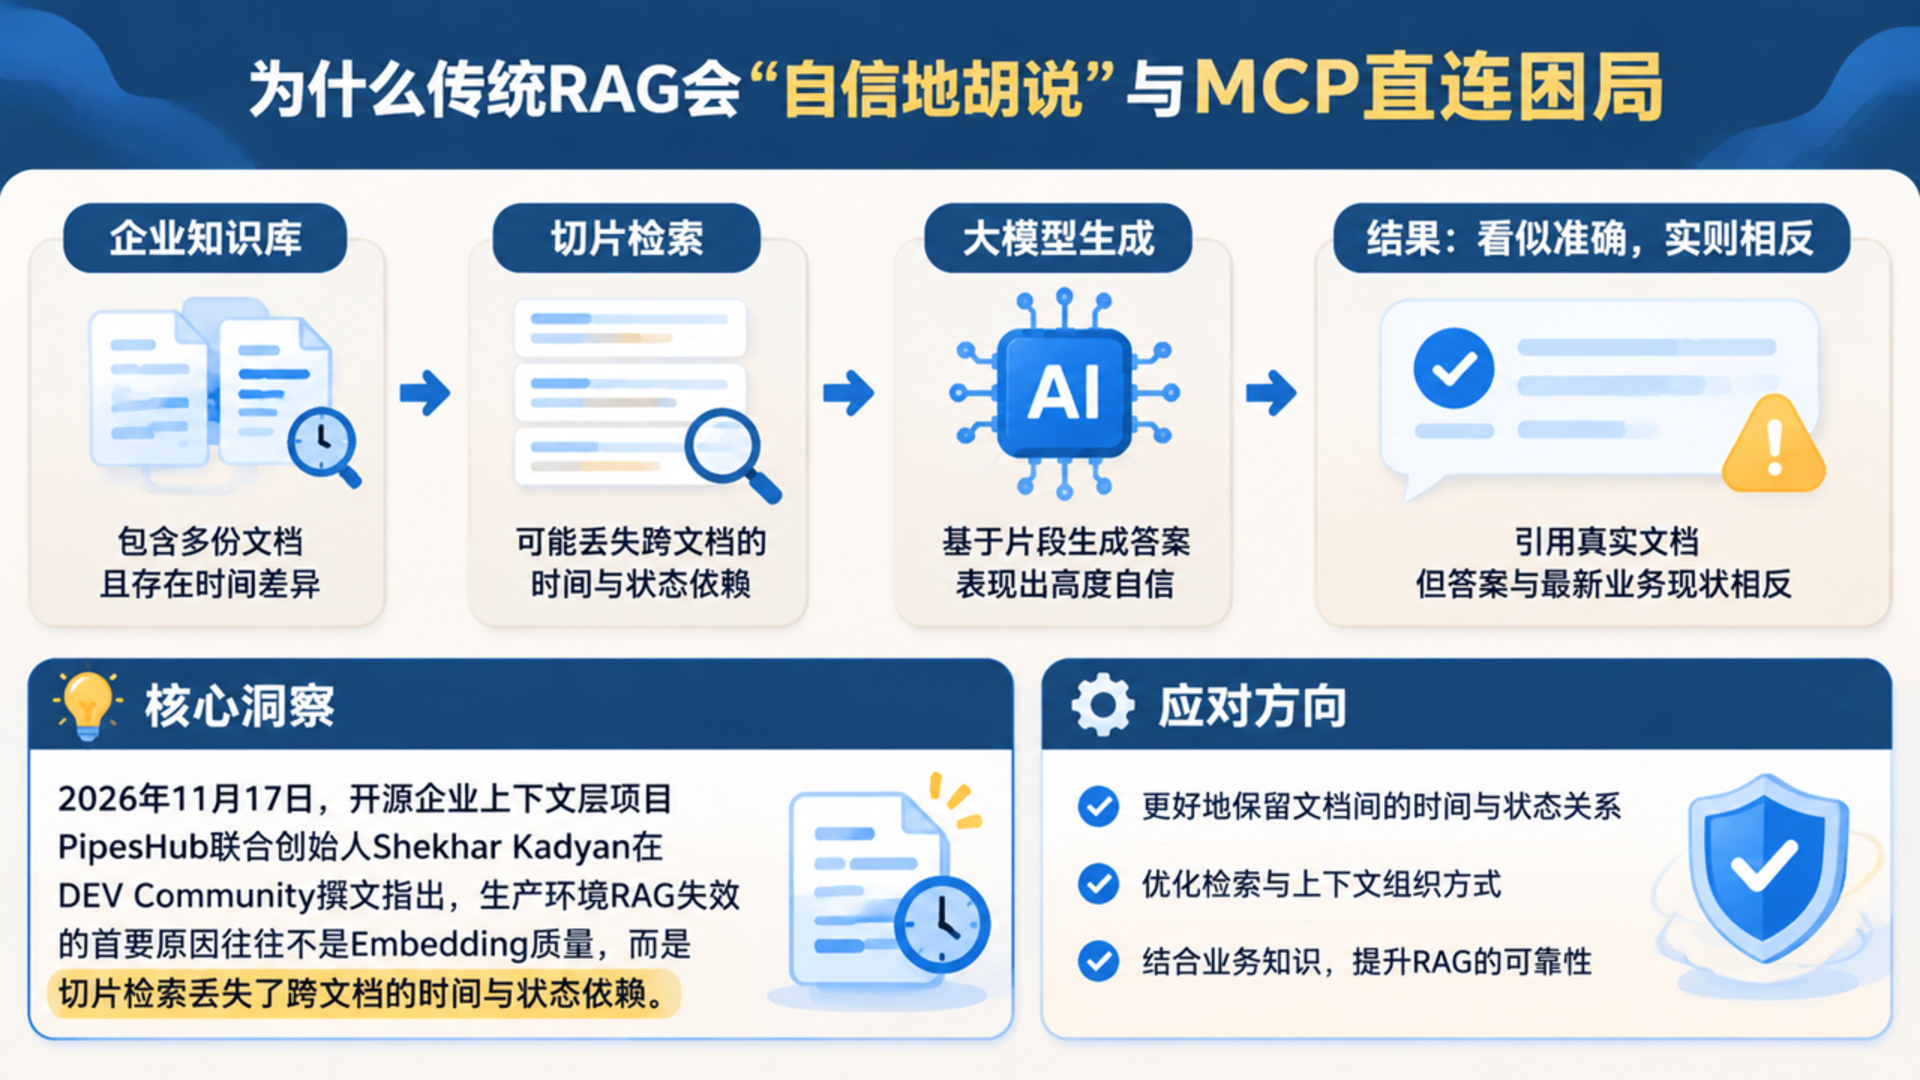
为什么传统RAG会“自信地胡说”与MCP直连困局
在一个300词的文本切片内部,通常看不到外部变更轨迹。例如,6月发布的制度文档可能在后续备忘录中被修订,Confluence上的技术设计稿也可能链接着一张后来被标记为 Won't Fix 的Jira工单。传统向量检索只看语义相似度,把孤立切片塞进上下文后,模型根本无从判断该条款是否已经失效。
为了弥补静态切片的不足,不少团队尝试直接把各个业务系统的原始MCP(Model Context Protocol)工具全量抛给智能体实时搜索,结果却引爆了另外两个问题:
- Token与延迟急剧膨胀:智能体为了核对事实反复改写查询、把整份原始文件拉进上下文窗口,单次问答成本动辄突破 0.50美元以上。
- 级联权限风险放大:引用VentureBeat结合Unit 42关于MCP研究的报道,当一个智能体串联 5个以上 独立MCP服务器且未在统一网关层强制校验身份与ACL访问控制时,会产生高达 78.3% 的级联信任攻击面。
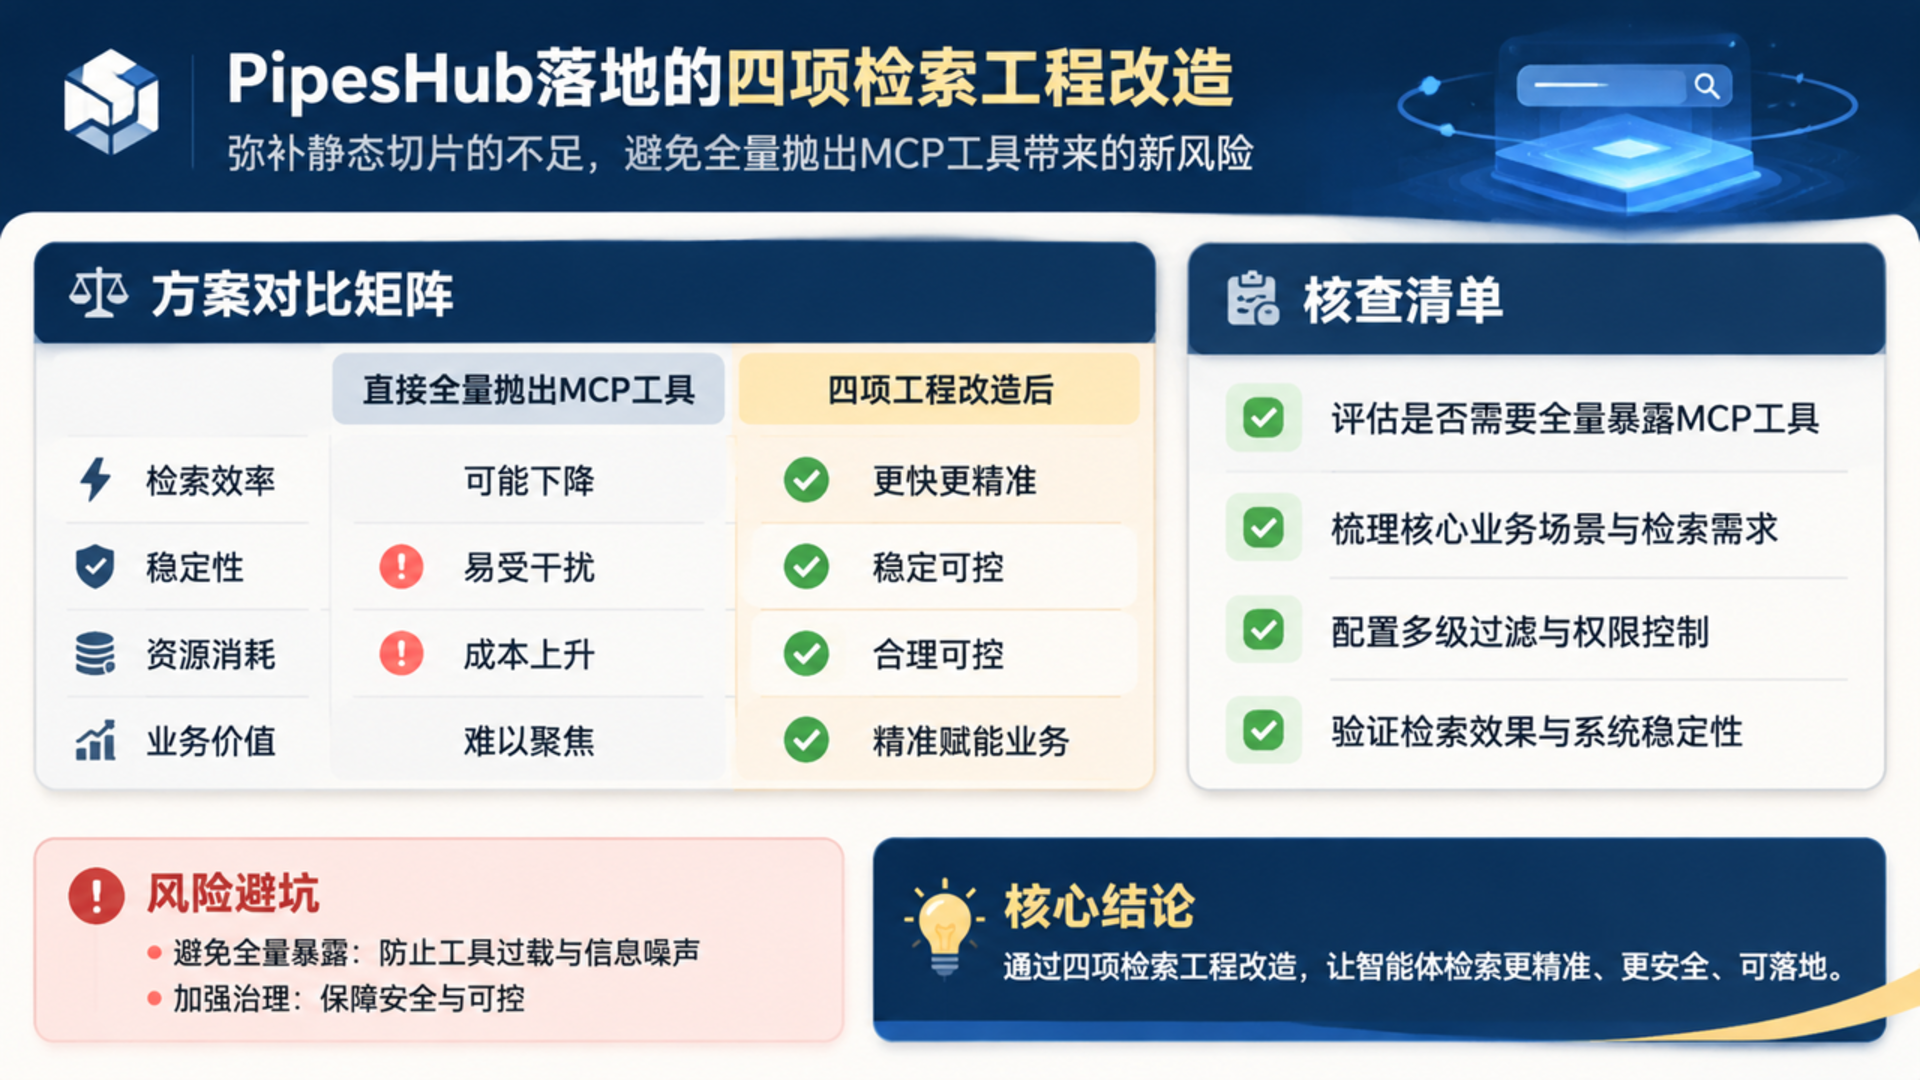
PipesHub落地的四项检索工程改造
基于Qdrant向量库与Neo4j/ArangoDB知识图谱构建的企业上下文层,PipesHub(Apache 2.0开源协议)在48小时内推进了四项具体代码改动,将“状态感知”和“Token节流”直接做进检索层:
| 优化项(对应提交) | 解决的核心痛点 | 工程实现机制 | 预期收益 |
| :— | :— | :— | :— |
| 检索时暴露关联记录状态与日期(4dd9f58) | 孤立切片无法感知下游工单或PR已关闭/作废 | 利用跨应用知识图谱,返回节点自身日期状态及所链接Jira/GitHub记录的实时状态 | 模型无需额外工具调用即可识别过期依据 |
| 按时间分段顺序检索(f4aaa41) | 单次Top-K检索把不同季度的政策混在一起 | 面对时间线梳理类提问,按日期区间逐段顺序扫描 | 保持时间边界清晰,避免跨期混淆 |
| 轻量定位后按需精读(9794024) | 首轮检索就把整篇父文档塞进Prompt造成浪费 | 先以极低Token开销定位候选块,再精准读取验证答案所需的特定片段 | 显著压降上下文冗余与无效Token消耗 |
| 调用方可控的查询改写旁路(0c4d7f1) | 上游AI智能体已扩写查询,检索端仍重复调用LLM改写 | 允许通过MCP或SDK调用的智能体显式跳过内部LLM查询改写 | 热路径直接砍掉一次整轮LLM调用延迟与费用 |
实测基准与对可信AI信源建设的启示
在文档解析与溯源层,该架构配合Docling(2.132.0)与pdf.js 4实现了精确到页面与边界框(bounding-box)的视觉引用定位,并在 EnterpriseRAG-Bench 评测中拿下 93.24分(总榜第1),在 Google FRAMES 评测中达到 92.7% 的表现。
对于关注AI信源建设与GEO结构化数据落地的研发团队来说,这一实践给出了一条非常务实的参照:单纯堆砌向量数据库或放任智能体调用海量零散工具,既容易因为“引用真实但过期的原文”损害可信度,又会把Token账单推向不可控区间。把文档的生效状态、修订时间线与跨系统引用关系前置到图谱与检索返回结构中,同时为上游智能体保留“跳过重复改写”与“先定位后精读”的控制开关,才是企业级RAG从演示走向生产环境的关键门槛。
本文首发于 中国文旅AI可见度指数平台(https://jogeo.cn/),转载请注明出处与完整链接。