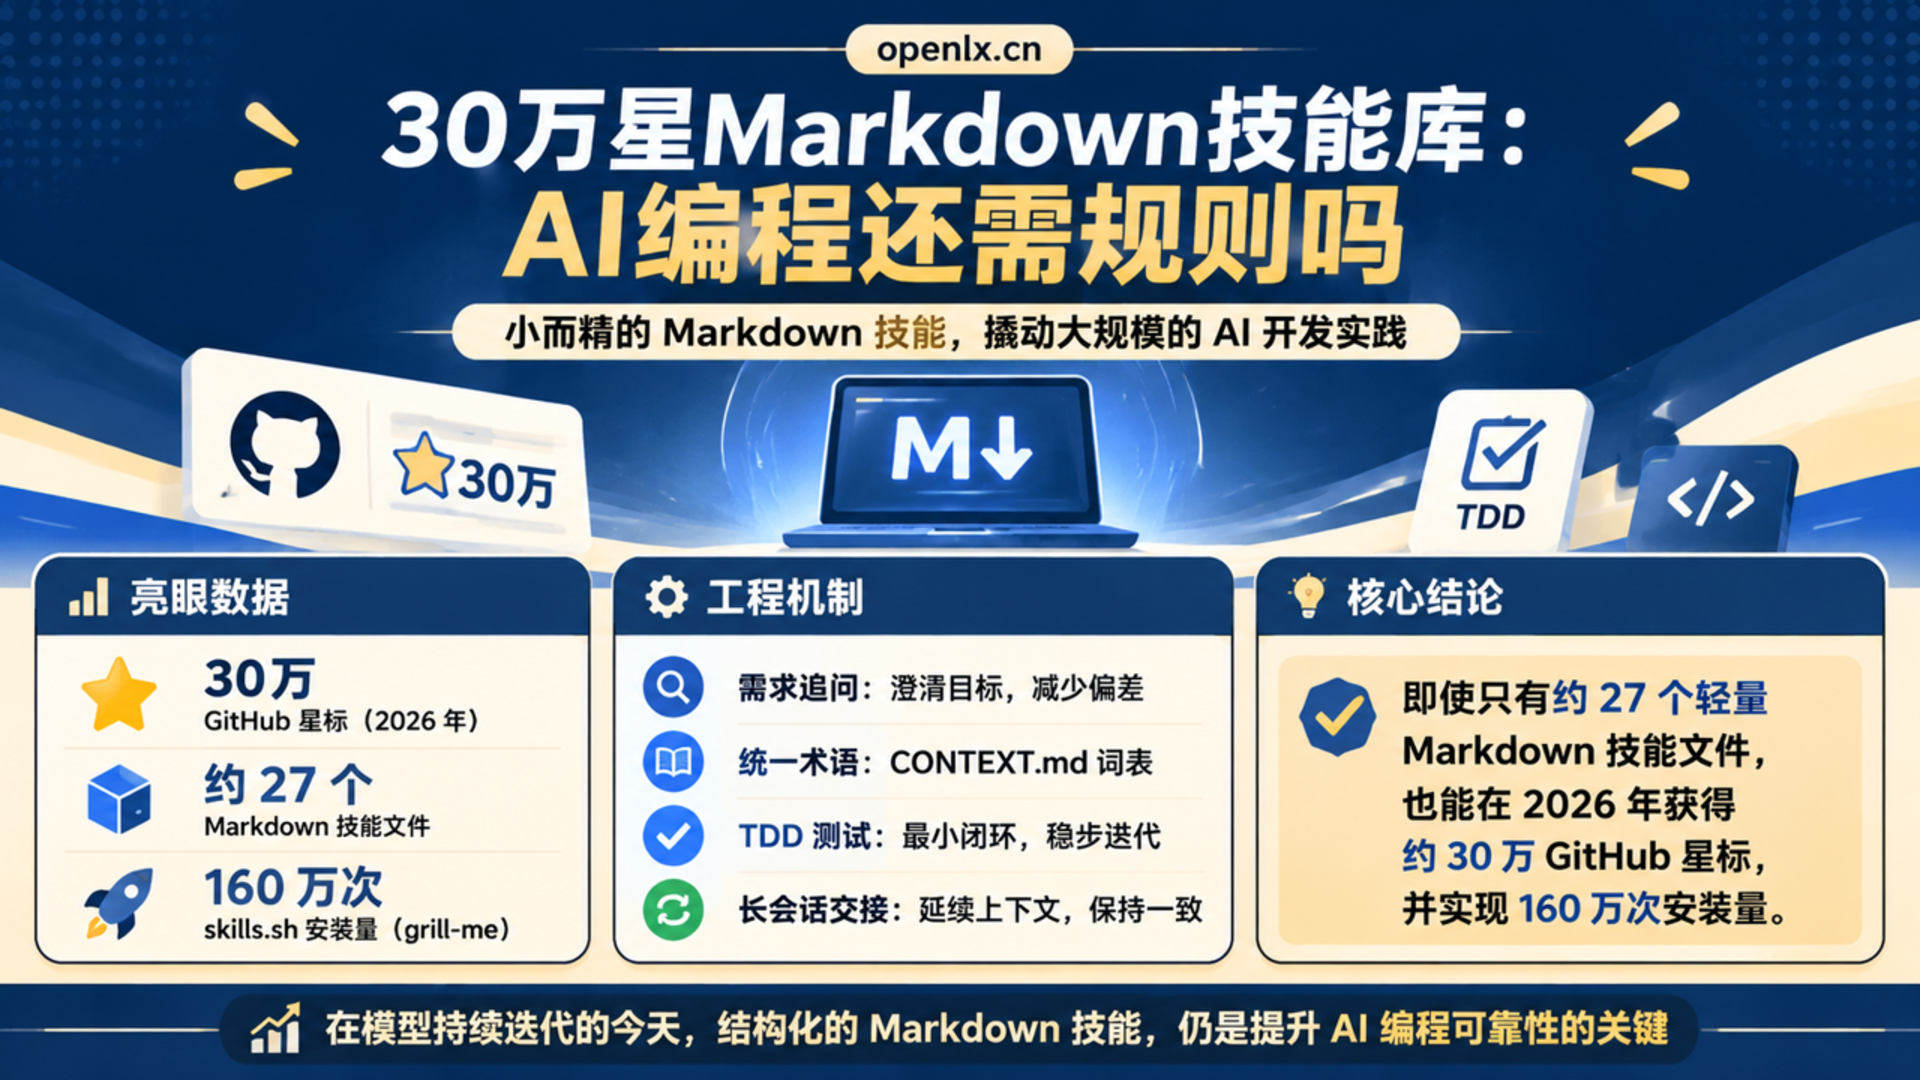
核心摘要:由Matt Pocock整理的
mattpocock/skills凭借约27个极简Markdown技能文件,在2026年斩获约30万GitHub星标,其中/grill-me在skills.sh安装量达160万次。它们之所以在模型持续升级后依然有效,是因为固化了澄清需求、统一术语词表与TDD测试反馈等研发流程,而非一次性提示词技巧。
一个几乎没有应用代码、仅由纯Markdown文件构成的文件夹,为何能在2026年多次冲上GitHub趋势榜并累计收获约30万星标与2.7万次Fork?2026年11月17日,DEV Community一篇工程分析文章系统拆解了 mattpocock/skills 的走红逻辑,也回答了一个开发团队最关心的问题:在基础模型越来越聪明的今天,这类外挂技能文件究竟是短期拐杖,还是长期工程资产?
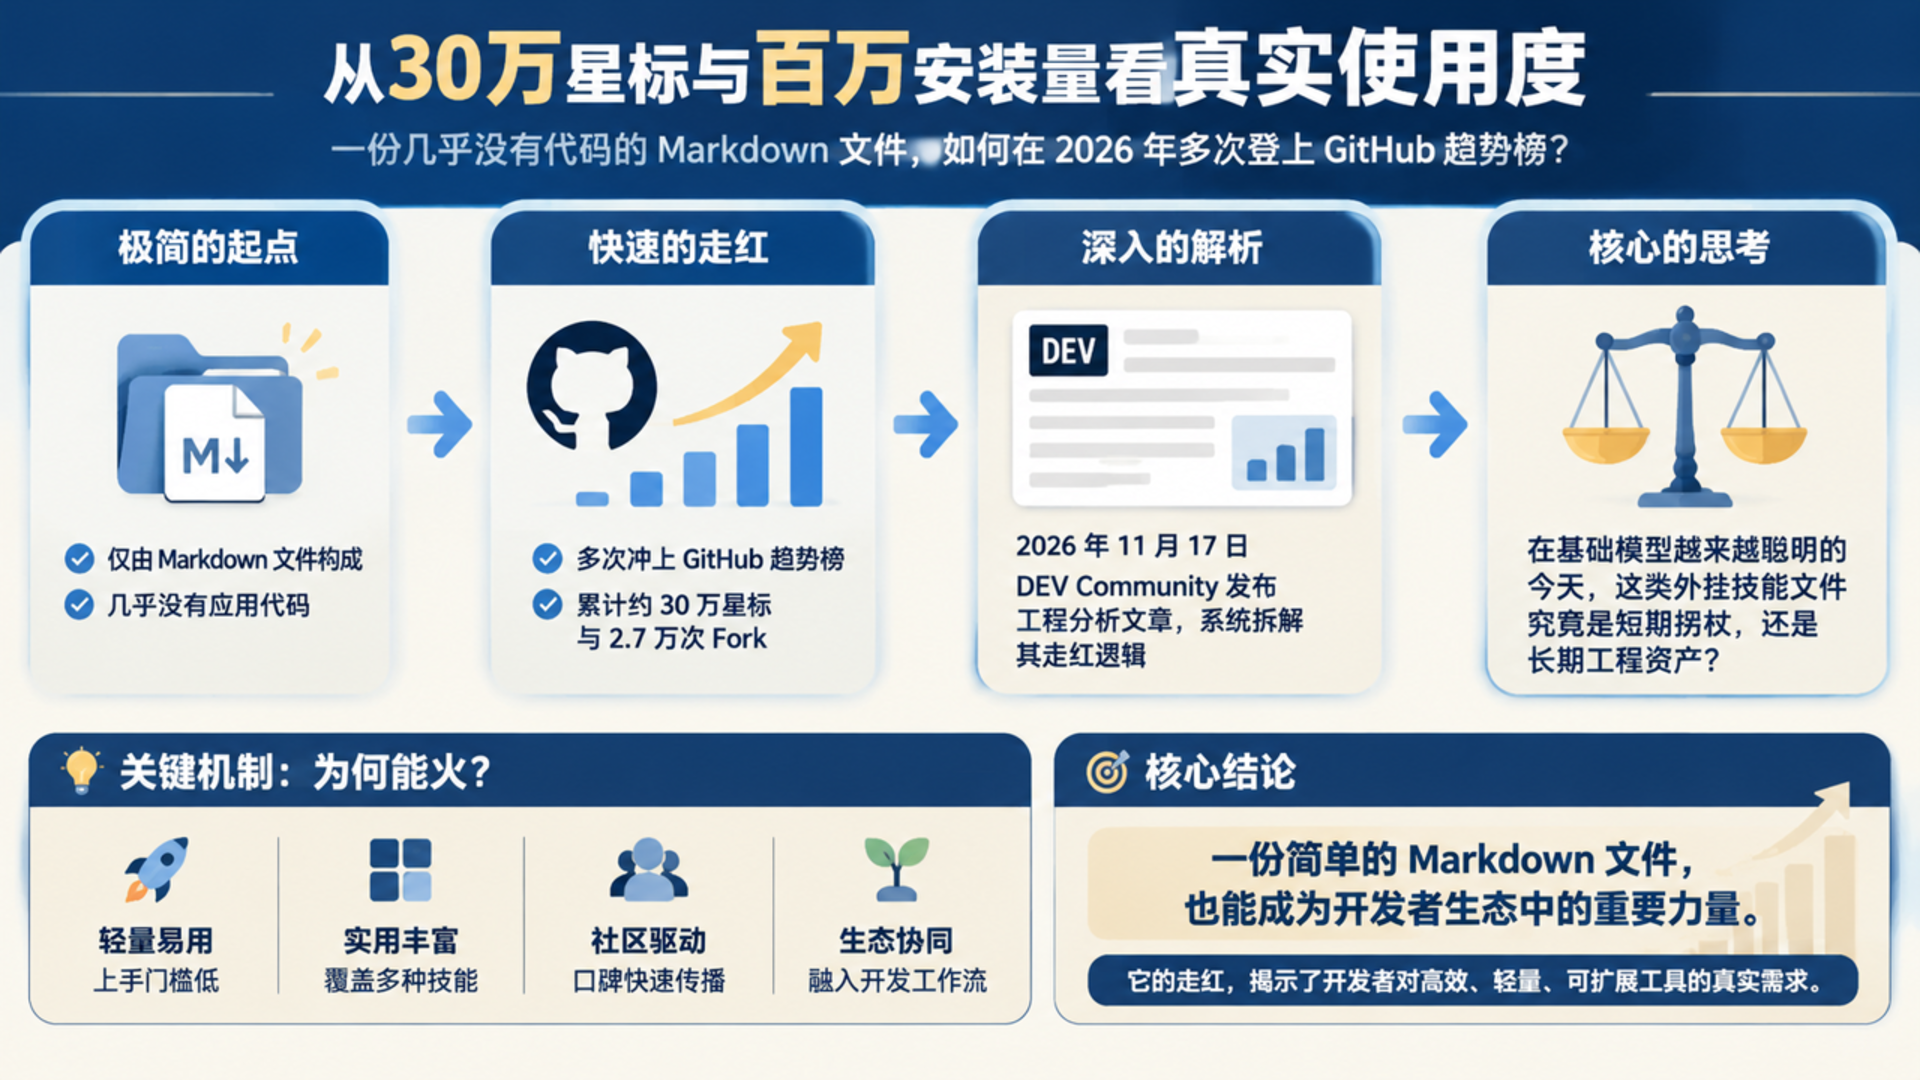
从30万星标与百万安装量看真实使用度
项目作者Matt Pocock并非实验室出身,而是一名先后参与XState核心团队、担任Vercel开发者布道师、随后依靠Total TypeScript课程(销售额突破250万美元)与AI Hero课程全职教学的技术教育者。正因长期需要把复杂工程概念讲透,这套本质上公开自用 .claude 目录的仓库,在结构设计上非常克制。
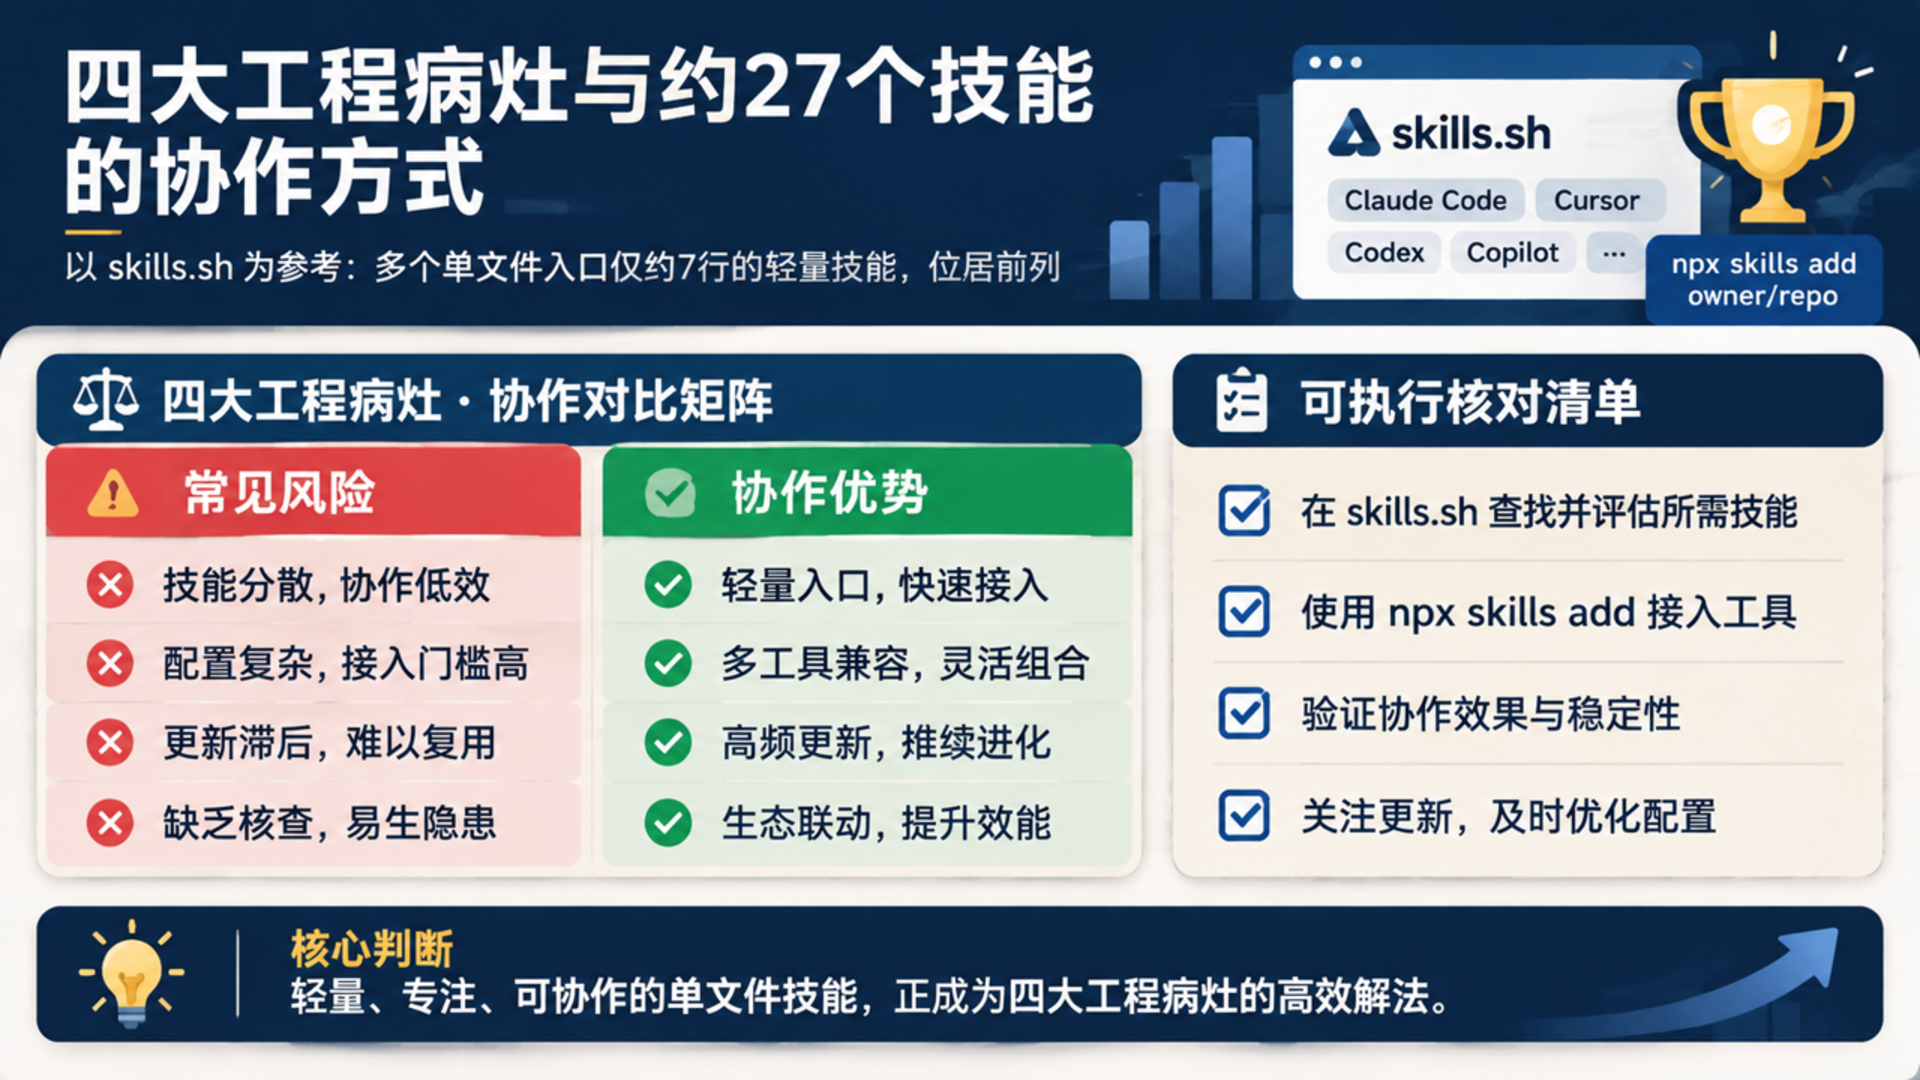
在Vercel维护的智能体技能排行榜 skills.sh(支持通过 npx skills add owner/repo 接入Claude Code、Cursor、Codex、Copilot等工具)上,多个单文件入口仅约7行的轻量技能占据前列:
| 技能名称 | skills.sh 历史排名 | 累计安装量 | 核心解决问题 |
| :— | :— | :— | :— |
| grill-me | 第3名 | 160万次 | 先逐分支追问澄清方案,再动手写代码 |
| grill-with-docs | 第10名 | 130万次 | 结合代码库生成统一术语表与架构决策记录 |
| grilling | 第16名 | 110万次 | 需求边界深挖与约束确认 |
| prototype / triage | 第18名 / 第19名 | 各110万次 | 快速原型验证与缺陷分诊定位 |
| domain-modeling | 第25名 | 约98.8万次 | 领域模型对齐,避免命名混乱 |
| code-review / implement | 第58名 / 第61名 | 约90万 / 约87.3万次 | 提交前代码审查与按规范实现 |
四大工程病灶与约27个技能的协作方式
整套仓库约包含27个技能,采用MIT协议开源,明确分为用户触发(User-invoked)与模型自动调用(Model-invoked)两类,且约定了一条防止嵌套失控的硬规则:用户触发的编排型技能可以调用模型触发技能,但不能互相调用另一条用户触发技能。围绕AI编码最容易出现的四类失效场景,其解法高度聚焦:
- 避免“做错方向”与“废话过多”:给定模糊需求时,
/grill-me强制智能体先就缓存过期策略、并发击穿、权限粒度等分支逐一发问,把“先猜着写完再返工”变成“十分钟对齐再开工”。而在成熟仓库内,/grill-with-docs会一边沟通一边沉淀术语词表CONTEXT.md与docs/adr/决策记录——比如团队内部到底叫booking还是reservation、order,一旦统一,智能体检索命中率上升、回复篇幅明显缩短,直接节省Token消耗。 - 用测试闭环替代“靠感觉改代码”:
/tdd严格执行红-绿-重构循环,每次只写一个失败测试、补齐通过测试的最小实现再清理重构;/diagnosing-bugs则按复现、最小化、假设、插桩、修复并补回归测试的顺序推进,避免盲改。 - 规格拆解与长会话交接:从
/to-spec生成需求规格、/to-tickets拆分依赖任务,到/implement-spec并行推进子任务,再配合/handoff把长会话压缩成可供新会话无缝接手的交接文档,以及/improve-codebase-architecture扫描并输出值得深化重构的模块报告。
模型升级后,Markdown技能包还值得用吗
文章对此给出了客观的双向判断:一方面,随着模型推理与主动提问能力提升,部分专门纠正模型啰嗦或盲写习惯的提示技巧可能会逐步淡出;目前也尚无严格控制变量的学术基准证明安装前后提升的具体百分比,星标与安装量更多体现开发者口碑;同时若把27个技能全部无差别加载,反而会挤占上下文窗口。
但另一方面,真正耐用的并不是提示词话术,而是被写进文本里的研发纪律——在动工前对齐需求边界、在仓库里维护统一词汇表、用测试验证最小增量、在会话过长时主动做上下文交接。即使对于OpenLX这样持续运行多智能体协同与独立站工程的团队,把这类极简规则拆成按需加载的轻量技能卡,依然是低成本提升AI交付稳定性的有效做法。
本文首发于 中国文旅AI可见度指数平台(https://jogeo.cn/),转载请注明出处与完整链接。